
ViT 对比 ResNet:Transformer 什么时候赢卷积
ResNet 用残差连接把深层网络训得动;ViT 在数亿张预训练图像上反超 CNN;CLIP 零样本追平 ResNet-50。决定胜负的是数据规模,不是架构。
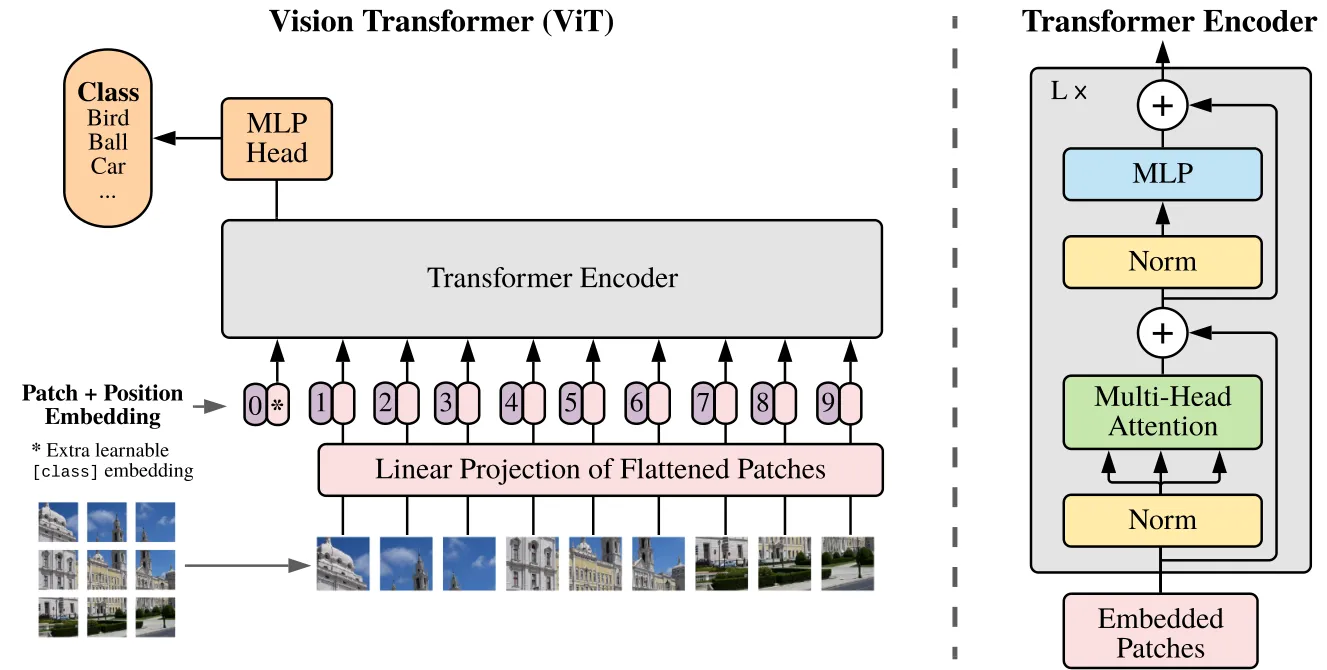
真正的设计分歧只有一个
两种架构的起点是同一个观察:网络越深精度越高,但越深越难训。ResNet(2015)从网络内部解决:跳连把输入原样传到块的输出上,每个块只需学一个残差修正,而不是完整映射。152 层网络第一次训得动(比 VGG 深 8 倍、FLOPs 反而更低),而残差这个原语后来成了通用件:每个 Transformer(包括所有语言模型)内部的残差流,就是同一个想法。
ViT(2020)从相反方向进攻:不修卷积网络,而是删掉它。把 224x224 的图像切成 196 个 16x16 的块,每个块拉平后过一个线性层变成 token,加一个 [class] token 和位置嵌入,直接喂给一台几乎未改动的语言 Transformer。没有卷积、没有局部性先验、没有平移等变:模型关于图像的一切知识都必须从数据里学。
CLIP(2021)保留了 ViT 式的图像编码器,但换了监督信号:不再预测固定的类别表,而是用对比目标让两个编码器去匹配 4 亿对网页图文;推理时把候选标签写成文字,比较图文嵌入的相似度就完成了分类。
所以这场对比不是”老 CNN 对新 Transformer”,而是三个下注:ResNet 赌难点在优化,ViT 赌难点在无偏架构的规模,CLIP 赌难点在监督信号。
关键数字
| 指标 | ResNet(2015) | ViT(2020) | CLIP(2021) | 同口径? |
|---|---|---|---|---|
| ImageNet 头牌成绩 | 集成 3.57% top-5 误差,ILSVRC 2015 第一 | ViT-H/14 top-1 88.55%,JFT-300M 预训练 | 零样本追平原版 ResNet-50 | 否,年份、指标、数据全不同 |
| 头牌成绩背后的训练数据 | 128 万张有标注 ImageNet 图像 | 3 亿张(JFT-300M,谷歌私有) | 4 亿对无标注网页图文 | 否 |
| CIFAR-10 | 为研究优化行为训过 100 层乃至 1000 层网络 | 99.50%(ViT-H/14) | 非重点 | 否 |
| CIFAR-100 | — | 94.55%(ViT-H/14) | — | 否 |
| VTAB 19 项任务套件 | — | 77.63%(ViT-H/14),不低于同期 BiT-L 卷积网络 | 零样本迁移 30+ 数据集 | 否 |
| 分类之外的迁移 | 同一骨干让 COCO 检测相对提升 28% | 早期层注意力即可覆盖全图 | 多个任务上接近全监督基线 | 任务各不相同 |
| 预训练算力 | — | 达到同等精度所需 TPU-core-day 少于 BiT / Noisy Student 卷积基线 | 对比式目标是因生成式字幕训练太慢无法扩展而选的 | ViT 行是和自家论文里的 CNN 基线比 |
注意这张表里没有什么:没有任何一篇论文在统一协议下训过这三个模型。ResNet 的数字是 2015 年的集成 top-5,ViT 是 2020 年单模型 top-1 且依赖私有 3 亿图数据集,CLIP 故意只拿 2015 年的 ResNet-50 当标尺,因为它 claim 的是通用性,不是榜单名次。任何把三者排成一场比赛的对比都是在误导。
真正决定胜负的:数据规模交叉点
ViT 论文里最值得引用的是那句诚实的话:只在 ImageNet(~130 万张)上预训练,ViT 打不过同规模的 ResNet;换 ImageNet-21k 大致打平;换 JFT-300M 才反超。这个交叉点就是 CNN 对 Transformer 之争的全部故事。
ResNet 内置了局部性、平移等变、二维邻域结构这些对图像天然正确的先验,所以在 130 万张数据的规模上,起步假设就对的模型赢。到了 3 亿张,这些先验从助力变成约束:Transformer 可以自由学数据里真实存在的任意结构,论文显示它自己在学习的位置嵌入和浅层注意力图里重新发现了空间局部性。规模买下了过去靠架构才能得到的东西。
这也是为什么”ViT 是不是比 ResNet 好”对你的项目是个问错了的问题。答案取决于基准数字从不打印出来的那个变量:你能触达多少预训练数据。
CLIP 的变招:换个游戏,而不是赢下一局
CLIP 和 ResNet 的关系更微妙。它没有在自己时代的 ImageNet 上击败最强的监督模型。论文自己写明:它追平的是原版 ResNet-50,一个 2015 年的基线,而且全程没用 ImageNet 的 128 万标注。它改变的是新增任务的成本:ResNet 或微调过的 ViT 每接一个任务都要新标注、再训一轮;CLIP 只换提示词(a photo of a {label}),同一套冻结权重就能从 ImageNet 搬到 OCR、搬到地理定位,在 30 多个数据集上非平凡地迁移。
代价论文也写明了:精度对提示词措辞敏感,数数量这类抽象任务偏弱,模型继承了未清洗网页数据的偏见。CLIP 是表示层面的突破,不是推理层面的,但它让自然语言成了视觉的控制面,后来所有多模态模型都建立在这个假设上。
怎么选
- **标注数据少或中等、算力预算紧:**从 ResNet 一系或数据高效版 ViT(如 DeiT)起步。ViT 在 ImageNet-1k 规模下本来就落后 ResNet,88.55% 的头牌成绩不属于你的数据区间。
- **有(或租得起)大规模预训练数据:**选 ViT。注意力的优势随模型和数据规模放大,论文实测在大盘上它以更少的 TPU-core-day 达到卷积网络的精度。
- **任务多、每类标签少、有文本可用:**CLIP 式对比预训练,然后零样本或线性探测。任务数一多、标签一少,换提示词比重训分类头划算。
- **检测、分割等稠密任务:**原始的平铺 patch 网格并不适配稠密预测,这块地盘属于层次化设计的后裔:ResNet 骨干和层次化 ViT 后代都在。
局限与存疑
ViT 的头牌数字依赖谷歌私有数据集 JFT-300M,外部很难复现;在大多数团队真实拥有的数据区间,卷积网络仍是更强也更便宜的选择。CLIP 追平 ResNet-50 说的是标签效率,不是峰值精度,提示词敏感意味着分数随措辞浮动。ResNet 的 3.57% 是集成绩,比单模型时应打折扣。而且这三篇论文都早于现代配方(自监督预训练、掩码图像建模、层次化注意力),弥合这些结果与当下实践差距的正是后来者。把这篇对比当作权衡关系的清晰陈述,而不是 2026 年选型的购买指南。
常见问题
视觉 Transformer 比 CNN 强吗?
取决于数据规模。ViT 自己的论文报告:在 ImageNet 规模(约 130 万张)数据上,ViT 打不过同规模 ResNet;在数亿张图像上预训练后,ViT-H/14 拿到 88.55% top-1,以更少预训练算力达到或超过同期最强卷积网络(BiT-L)。
为什么 ViT 比 ResNet 吃数据?
因为 ResNet 内置了局部性、平移等变这些先验,而 ViT 把它们全部剥掉、改从数据里学。低于数据阈值时,内置先验赢;越过阈值,它们变成约束,灵活的架构赢。
CLIP 在 ImageNet 上打败 ResNet 了吗?
不是头条暗示的那种”打败”。零样本 CLIP 在不使用 ImageNet 128 万训练标注的前提下,追平了原版 ResNet-50。它在难而专的数据集上仍落后更强的监督模型;它的贡献是用一个冻结模型零样本横跨 30 多个任务,而不是任何单一榜单的第一。
ResNet 和 Transformer 有什么关系?
残差连接。ResNet 残差块”输出 = 输入 + 学到的修正量”,和每个 Transformer 编码层里的残差流是同一个机制,这也是为什么讲深度学习史时,ResNet 通常被当作现代技术栈的前奏,而不是 Transformer 的对手。