
Stream-T1 与 VLM 教师优化对比:不重训,推理时买视频质量
Stream-T1 靠推理时搜索把 5 秒运动质量从 0.350 提到 0.629;VLM 教师逐样本微调 LoRA,把 RULER 从 46.4 拉到 68.2。都不重训,只花推理算力。
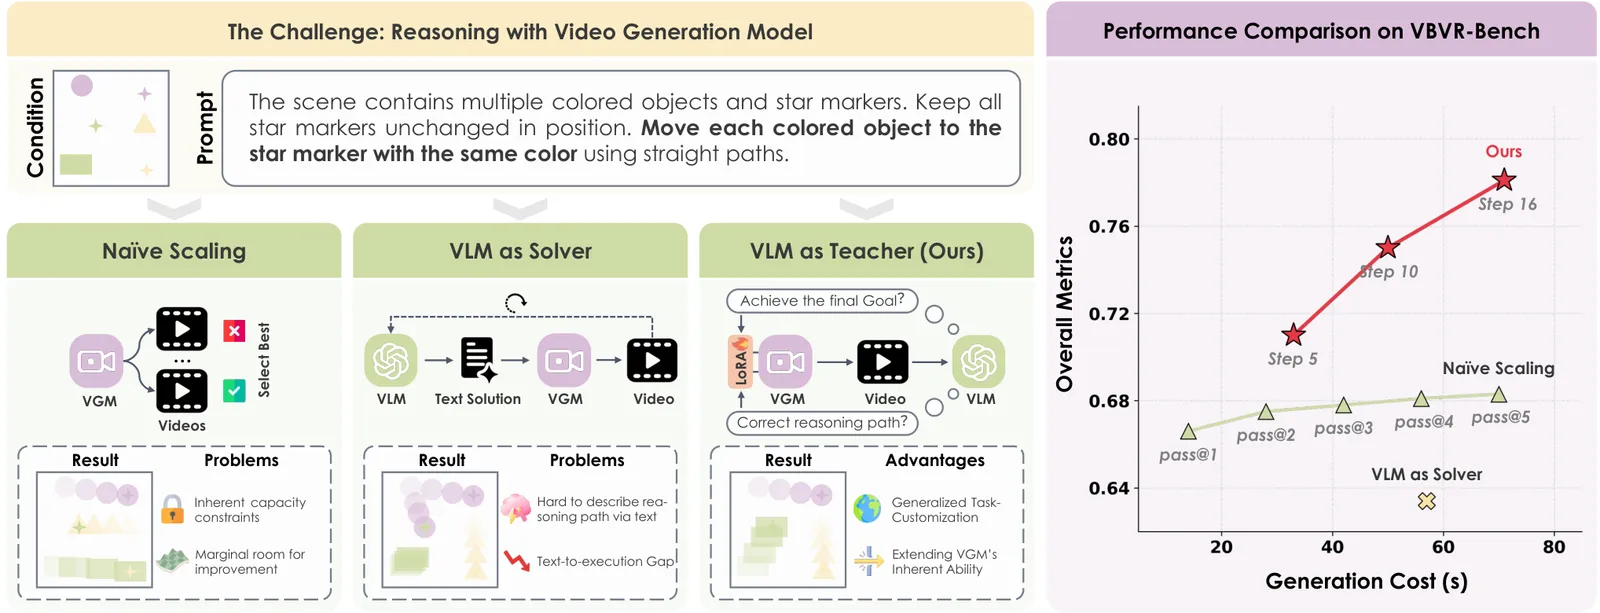
同一个赌注:不重训,推理时把质量买回来
这两篇论文的出发点都是同一个拒绝:重训视频模型太贵、太慢,而且你手里往往只有一个发布出来的 checkpoint,改不了权重。于是它们改问:如果把同样的预算从训练时的梯度步数挪到推理时的算力,一个冻结的视频模型还能把多少质量买回来?这就是「测试时计算」(test-time compute)这一整个家族,而两篇论文花的货币正好相反。
Stream-T1 花的是搜索。它包住一个冻结的自回归流式视频生成器,每个视频块(chunk)展开几条候选续写,用奖励模型打分、剪枝。全程没有任何一次反向传播优化;模型是一件固定 artifacts,只是被问得更聪明。VLM 教师 那个循环花的是梯度步数。它同样冻结视频模型,但外挂一个极小的逐样本 LoRA,在推理时微调这几个适配器参数。打分的是一只视觉语言模型(VLM),它盯着中间帧,自己出题、自己阅卷。
两者要治的病也不一样。Stream-T1 治的是保真度漂移:流式模型一块一块生成时累积的主体变形、背景乱走。VLM 教师循环治的是推理失败:视频动作流畅、画面漂亮,但任务根本没完成,比如「把每个彩色物体移到同色星星标记处」。所以怎么选,看的不是谁的数字大,而是你的失败属于哪一种。
各自怎么工作
**Stream-T1:穿上视频专用零件的束搜索。**三个免训练机制逐块配合。流式噪声传播用球面插值把上一块的噪声接进新块的 latent(插值因子取值 -1 到 1),而不是每块重新采样噪声,动作于是连贯、不重启。流式奖励剪枝是核心:每个块展开多条候选,用图像奖励算的短程分(单帧质量)加视频奖励在 10 块滑动窗口上算的长程分(时序一致性)联合打分,再用动态阈值剪枝:阈值随片长把权重从单帧质量移向与历史一致。流式记忆沉降处理被挤出 9 帧窗口(注意力 sink 占 3 帧)的 KV 缓存条目:检测到语义边界时,它们被丢弃、EMA 平滑进 sink、或直接追加,陈旧上下文不至于毒化新帧。
**VLM 教师循环:一只从不亲自解题的阅卷人。**教师 VLM 先读任务条件,自己合成监督信号:一个目标达成问题(「最终帧满足目标了吗?」)加 M 个过程监督问题,M 通常在 1 到 3 之间。在学生视频模型去噪的过程中,VLM 把预测帧当作多题 VQA 来回答,而 VQA 损失是可微的,梯度于是穿过预测帧流进那个小 LoRA。没有 RL、没有训练奖励模型、没有策略梯度噪声。损失降到阈值以下或到达步数上限就提前停:简单的样本少花算力,难的样本多花。
关键数字
| 维度 | Stream-T1 | VLM 教师循环 | 设置与来源 | 同口径? |
|---|---|---|---|---|
| 干预方式 | 免训练的块级搜索:噪声传播、奖励剪枝、记忆沉降 | 可微 VLM 阅卷奖励驱动的逐样本 LoRA 优化 | 两者都冻结视频 backbone | 不适用 |
| 短片头条增益 | 5 秒 VideoAlign MQ 0.350→0.629;VQ 0.285→0.426;TA 1.193→1.305 | RULER-Bench 46.4→68.2(+21.8) | Stream-T1 对 LongLive,946 条 VBench 提示;教师法对 Wan2.2-5B-Distilled 冻结基线 | 否 |
| 长片头条增益 | 30 秒 VideoAlign MQ -0.002→0.226;VQ -0.169→-0.073 | VBVR-Bench 0.666→0.781(+0.115) | Stream-T1 用 128 条 MovieGen 提示、16 FPS、832×480;教师法用符号推理基准 | 否 |
| 接近饱和的 VBench 指标 | 5 秒:运动平滑 99.12→99.15、主体一致 97.00→97.25;30 秒:美学 61.56→62.11、主体 97.90→98.43、平滑 98.78→99.03 | n/a | 仅 Stream-T1;基线本就 97 到 99,几乎没有余量 | 是(文内) |
| 消融 | (页面未把三个机制拆开给数字) | VBVR:去掉目标奖励 0.692(−0.089);去掉全部任务奖励 0.712(−0.069);去掉过程问题 0.758(−0.023) | 教师论文,满分 0.781 | 是(文内) |
| best-of-n 基线 | 隐含对照:单轨迹基线在 30 秒崩掉 | Pass@5:VBVR 0.683 / RULER 49.1(仅 +0.017 / +2.7);VideoTPO:VBVR 0.634(−0.032)、RULER +3.9 | 暴力采样 vs 结构化奖励优化 | 是(文内) |
| 失败审计 | 奖励模型盲区(页面无数值) | 50 个失败样本:42 个(84%)是 VLM 感知错误,8 个(16%)是奖励问题出错;教师能力与 RULER 分数相关 R²=0.733 | 教师论文自己的错误分析 | 是(文内) |
把各行对照着读,图景是一致的:Stream-T1 的大数字长在奖励模型指标(VideoAlign)上,因为 VBench 一致性指标早已饱和在 97 到 99,几乎没有头部空间;它真正值钱的行在 30 秒:运动质量从几乎为零抬到 0.226。教师论文的大数字(+21.8)也带着自己的诚实砝码:符号类 VBVR-Bench 上只涨 +0.115,失败审计更明说天花板在阅卷人的眼睛,不在优化器。
两篇论文各自真正在主张什么
Stream-T1 的主张是:冻结的流式模型把真实余量落在了桌面上,纯推理时搜索能把它买回来,而且最大的收益恰好落在流式模型通常崩掉的位置:可靠时长之外。证据刻意收窄:一个基线(LongLive)、两个基准、832×480、最长 30 秒。论文也承认自己的方法制造的紧张:每块展开并打分多条候选会成倍增加推理算力,这和「实时流式」的定位是拧着的。
VLM 教师论文 的主张是:多采样换不来推理,结构化奖励加逐样本优化才换得来。采样 5 次取最好(Pass@5)在 VBVR-Bench 上只加 +0.017、在 RULER-Bench 上只加 +2.7,而教师循环加 +0.115 和 +21.8;另一个偏好优化基线(VideoTPO)甚至把 VBVR 拉到 0.634。消融支撑机制叙事:最终目标问题是最重要的一路(去掉掉 0.089),而 R²=0.733 的相关性和 84% 的感知错误审计定义了天花板:换一只更强的教师 VLM 数字就会动,但方法本身修不了一只看错画面的教师。
怎么选
- **流式模型长片漂移、又不能重训:**选 Stream-T1。它是外壳不是新生成器:噪声传播、奖励剪枝、记忆沉降这套食谱包在冻结的流式模型外面,而它最大的增益(30 秒 MQ 从 -0.002 到 0.226)正好落在漂移区间。
- **视频动作流畅但任务失败:**选 VLM 教师循环。如果失败模式是「画面没问题但约束没满足」,对块的搜索帮不上忙;检查目标达成与推理路径的阅卷人才对症。
- **要实时出片:**两个都慎重。Stream-T1 定位是流式,但它的搜索成倍增加每块算力;教师循环干脆是逐样本的推理时训练,延迟远高于单次前向。
- **只有 API 权限、拿不到权重:**Stream-T1 更接近可行(仍需对每个候选打奖励分);教师循环要穿过视频模型去噪过程反传,通常要求自己持有权重。
- **也在考虑免训练的采样器修改:**像 MIGA 这类方法只改冻结采样器的运行方式、不做每块候选展开,长视频稳定性更便宜,是付搜索费或优化费之前值得一试的第一步。
局限与存疑
还没有人把这两个方法放进同一套评测,上表也逐行标明了这一点:Stream-T1 的数字来自 LongLive 基线与 VBench、MovieGen 提示;教师法的来自 Wan2.2-5B-Distilled 与 RULER-Bench、VBVR-Bench。不同 backbone、不同分辨率、不同任务(保真度 vs 推理),所以「搜索对优化」还没有同口径答案。Stream-T1 继承奖励模型的盲区(猛优化 VideoAlign 可能漂向评分器喜欢的东西)、只报了一个基线、搜索与实时延迟的矛盾没有解决。教师循环继承阅卷人的感知上限,且只在 step-distilled 的 5B 学生模型上做过验证,逐样本优化的成本真实存在但页面上没有量化。两篇留下的开放问题是同一个:当测试时计算是货币,汇率是多少,多少延迟换回多少质量,而两篇都没有给它标价。
常见问题
Stream-T1 的 +0.28 MQ 和 VLM 教师的 +21.8 RULER 分能直接比吗?
不能。这是不同任务上对不同冻结基线的不同指标:5 秒流式片段的 VideoAlign 运动质量,对任务约束生成的 RULER-Bench 推理分。跨论文能下的结论是关于赢的形状而不是大小:两者都大幅移动自己的奖励类指标,而接近饱和的传统指标(Stream-T1 一例里的 VBench 一致性)几乎不动。
Stream-T1 和 VLM 教师循环需要重训视频模型吗?
都不重训 backbone。Stream-T1 完全免训练,只在推理时对候选块做搜索。教师循环同样冻结视频模型,但会在推理时微调一个极小的逐样本 LoRA。所以它不花训练算力,却需要对模型有梯度访问权,而不只是多跑几次前向。
为什么 VLM 教师循环在 RULER-Bench 上比「采样 5 次取最好」强那么多?
因为多采样只是探索,结构化奖励加逐样本优化才是定向。Pass@5 在 RULER-Bench 上只到 49.1,教师循环到 68.2;论文的解读是,暴力采样只增加多样性、没有反馈,而教师的目标与过程问题在告诉优化器这一次具体错在哪。
各自真正的天花板是什么?
Stream-T1 卡在它的奖励模型上:VideoAlign 大幅动了,但它也继承了奖励模型看不见的东西。教师循环卡在阅卷人的感知上:审计的失败里 84% 是教师 VLM 没看见细微画面错误,而且 RULER 分数与教师能力的相关是 R²=0.733。两种情况里,天花板都是评分器,不是生成器。
流式场景应该先试哪个?
如果症状是长片漂移,先上便宜的免训练方案(MIGA 这类采样器对齐,之后如果付得起每块的搜索算力再上 Stream-T1),因为 Stream-T1 的收益恰好集中在那个区间。如果症状是短任务上的约束违背,教师循环直击那个失败,但前提是你能在推理时穿过自己的模型反传梯度。