
相机、身体、嘴唇怎么控:三篇可控视频生成对比
三篇 2026 年的视频扩散控制工作分别管住相机、身体和嘴唇三条轴,且都用同一个办法破局:把挡路的中间表示换成直接从数据里算出来的条件信号。
这个问题里立着两堵墙
文生视频模型按提示词生成漂亮的画面,但生产场景很少要”一条漂亮视频”,它要的是这条运镜、那个人的动作、那张嘴对上这段音频。把这类控制灌进视频扩散模型,会撞上两堵墙中的一堵。
第一堵是数据墙。教模型控制相机的自然办法是”跨配对”数据:两条相机轨迹完全一致、内容却不同的视频。这种数据几乎没有,合成替代又有域差。教模型做角色动画的自然办法是(参考图、驱动视频)配对数据,于是姿态驱动方法先把驱动视频压成骨架图,而恰恰在压缩这一步,手与物体的接触、衣服的物理细节、两个人之间的交互,全都被扔掉了。
第二堵是延迟墙。最强的音频驱动方法要把整段clip双向处理完才吐第一帧,对口型质量是好,延迟却没法用:在 Lip Forcing 自己的表格里,14B 的 OmniAvatar-LS 基线只有 0.38 FPS、首帧延迟 213.72 毫秒。直播数字人根本建在这上面。
本页对比的三篇论文(OmniDirector、SCAIL-2 和 Lip Forcing)各自负责一条轴(相机、身体、嘴唇),也各自用一个共同的动作绕开自己的墙:把手工的中间表示换成模型能直接学的信号。
关键数字:三条控制轴一图速览
| OmniDirector | SCAIL-2 | Lip Forcing | |
|---|---|---|---|
| 控制轴 | 相机轨迹与镜头转场 | 角色身体动作与身份绑定 | 唇形与音频同步 |
| 条件信号 | 渲染成 3D 网格视频的相机轨迹 | 直接拼接进上下文的原始驱动视频 token | 音频 + 已生成帧,分块因果生成 |
| 底座 | 多模态扩散 Transformer(token 拼接) | Wan2.1-14B-I2V 全量微调 | 从 14B 双向教师蒸馏出的 1.3B / 14B 因果学生 |
| 数据墙对策 | 网格从视频自身算出:每条视频自成训练对 | 用智能体管线合成 MotionPair-60K | 蒸馏代替新数据 |
| 延迟对策 | 无(离线生成) | 无(离线生成) | 每块只去噪两步,推理期不用 CFG |
| 代表数字 | 旋转误差 2.64° vs 4.11(CamCloneMaster) | Studio-Bench FVD 287.11 vs 305.31(Wan-Animate) | 31.58 FPS vs 3.23(LatentSync),Sync-C 6.88 vs 8.10 |
| 边界 | 480p 短片;长序列一致性未验证 | 精度受合成数据生成器封顶;不含对口型 | 仅在 33 条 HDTF 上评测;最快的点不是最准的点 |
这三个数字不来自同一基准,也不该读成三者之间的排名,它们回答的是三个不同的问题。可比的是模式:每篇的头条指标都是在自己这条轴上对上一代最优方法量的,而且差距总是出现在新条件信号拆掉瓶颈的地方,其余地方只是渐进改善。
OmniDirector:不靠跨配对数据的相机控制
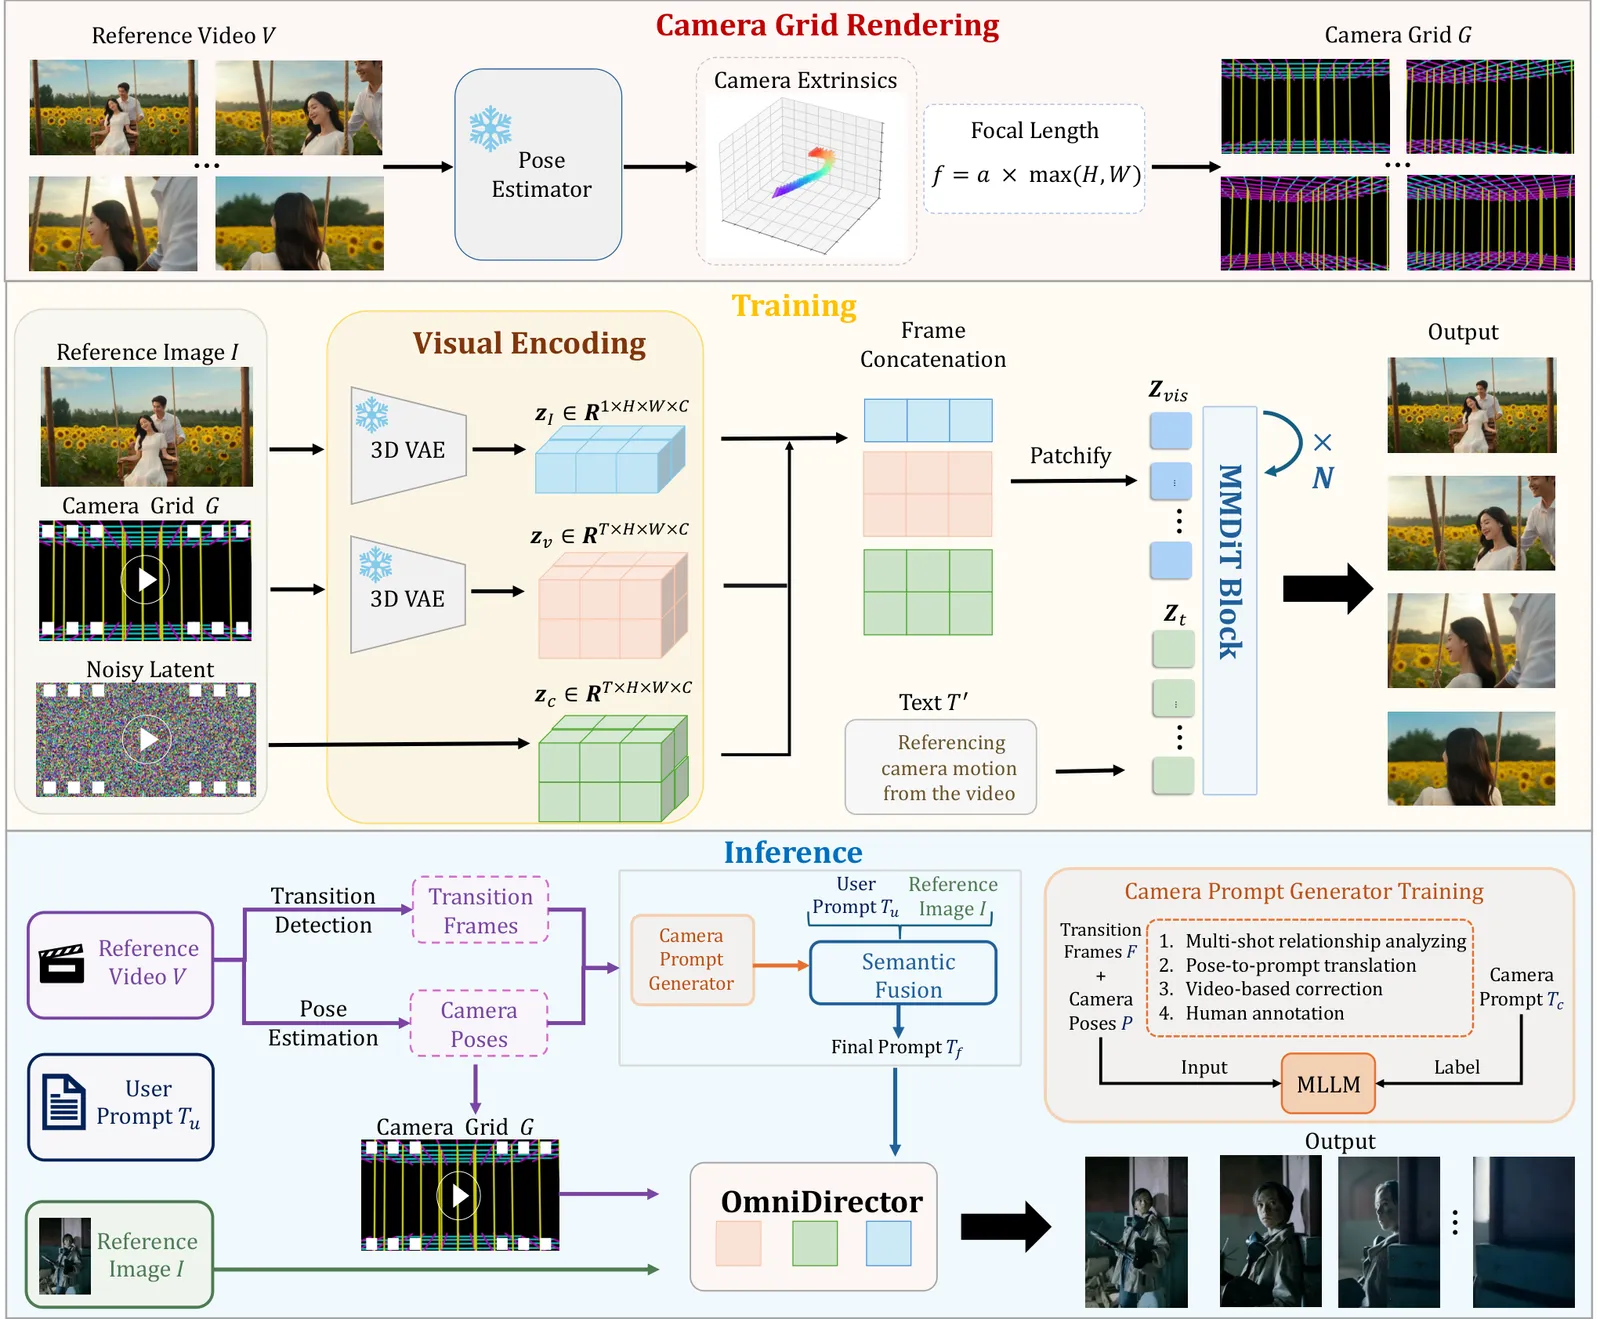
OmniDirector 面对的是最纯粹形态的数据墙。相机克隆需要两条运镜一致、内容不同的视频,这种数据集基本不存在。论文的做法是换掉相机的表示方式:不用位姿矩阵或文字描述,而是把轨迹渲染成相机网格:一个空三维房间里,红蓝正交线标出天花板和地板,黄线标墙,一根管子描出路径,全部由估计出的相机参数算出。因为网格来自同一条视频,互联网上任一条视频都自成训练对。作者用 TransNet-V2 过滤出 180 万条普通网络视频做训练,其中 30% 是自重建样本,逼模型真的去读几何信息。
单镜头的提升真实但渐进:1,094 条网络评测集上旋转误差(RRE)2.64 度,CamCloneMaster 为 4.11;平移精度 72.74% vs 52.21%。真正拉开差距的是多镜头:以往的克隆方法无法复现”切一刀、换一个新机位”;CamCloneMaster 的转场时序精度只有 2.20%,LTX-LoRA 为 38.94%;OmniDirector 把转场帧渲染成纯白、分别生成镜头间与镜头内的相机提示词,把时序精度做到 96.52%。内容泄漏也降到 0.51%(帧)/ 3.38%(镜头),对手是 1.60% / 11.59%。还有一个值得记住的调度细节:把网格只在高噪声步注入、其余信号在低噪声步注入,消融后旋转精度从 83.18% 掉到 74.55%。
论文自己写明的边界是:token 拼接”扩展到明显更长的视频序列时难以维持长期记忆与时序一致性”,且所有结果都在 480p 上测得。另外训练标签和评测都用 DPA-V3 估相机外参,指标可能继承该估计器的系统偏差。详见 OmniDirector 论文页。
SCAIL-2:去掉姿态骨架的角色动画
SCAIL-2(智谱 AI 与清华)拆的是另一个中间表示:姿态骨架。Wan-Animate 这类姿态驱动方法在生成前先把驱动视频转成骨架,骨架编码不了的信息(手物接触、衣服细节、双人交互)在模型看到之前就被丢弃。SCAIL-2 直接拿掉中间层:I2V 底座吃进去的是参考 token、加噪视频 token 和原始驱动视频 token 的拼接,驱动 token 做了固定空间偏移,与输出帧保持隔离。
光有原始条件还不够:模型怎么知道该抄谁的动作、留哪边的背景?SCAIL-2 加了一个上下文掩码,共 28 个额外通道:一个环境开关通道(动画任务留参考图背景、替换任务留驱动视频背景),六个绑定槽通道把动作绑到具体角色上,多角色场景零样本成立。数据问题靠合成解决:智能体循环(候选选择器、提示编织器、质量检查器)造出 MotionPair-60K:约 31,895 对 SCAIL 动画对、13,847 对来自 Wan-Animate、13,634 对 MoCha 替换对,外加约 10 万对姿态提取数据。之后再跑 400 步偏置感知 DPO,专攻合成数据在精细区域留下的伪影。
Studio-Bench 姿态驱动评测上,配 SAM3D-Body 网格的 SCAIL-2 拿到 SSIM 0.6453 / FVD 287.11,Wan-Animate 是 0.6340 / 305.31,VACE 是 0.5942 / 387.52,UniAnimate-DiT 是 0.6367 / 480.15。两个细节要带进决策:其一,网格很重要:把 NLF-Pose 骨架换成 SAM3D-Body 网格,SSIM 零样本从 0.6370 升到 0.6453;纯骨架驱动时模型表现平庸,说明部分增益来自更强的驱动表示而非架构本身。其二,消融显示设计件件承重:去掉绑定槽,Video-Bench 画质从 4.63 掉到 4.47;去掉替换任务,掉到 3.90。代价是一次 14B 全量微调(64 张 H100 约一周)加一整套合成数据管线。详见 SCAIL-2 论文页。
Lip Forcing:不再等整段视频的对口型
Lip Forcing(KAIST AI 与 AIPARK)正面撞延迟墙。LatentSync 这类强模型双向处理整条视频:Sync-C 8.10,但只有 3.23 FPS。Lip Forcing 用分布匹配蒸馏(DMD,与文生视频里的少步方法 Causal Forcing 同族)把 14B 双向教师变成因果学生:每个新块只依赖已生成帧和音频,输出可以流式吐。
让两步调度立住的三个零件:学生只在 (0, 30) 两个 ODE 索引上去噪,落点由欧拉步分析推得,在身份保持与音频跟踪间取平衡;Sync-Window DMD 把无分类器引导按去噪步分区:只在第 20–40 步施加 4.5 的引导强度,因为没有任何固定强度能在同步与保真上双赢;再用 SyncNet 置信度做奖励加权(w = exp(2·R)),同步好的样本在训练中拉得更狠。
数字全部出自 33 条 HDTF 测试集(真值 Sync-C 7.95,Sync-D 6.92):1.3B 学生跑到 31.58 FPS,首帧延迟 0.32 毫秒,Sync-C 6.88,FVD 118.86,FID 6.76,比同规模双向模型快 17.6 倍;14B 学生 15.11 FPS、Sync-C 7.59,把与真值的差距收得很小,同时比教师快 39.8 倍、比 LatentSync 快 4.7 倍,FID 还相当(7.01 vs 6.90)。代价说得很直白:最快的点同步最弱;且 Wav2Lip 在裸同步指标上仍更高(8.56),只是画面差得多(FID 24.15)。它的卖点是”流式速度下的写实感”,不是 Sync-C 冠军。详见 Lip Forcing 论文页。
底层的同一个动作:拆掉中间表示
把三篇并排看,它们在把同一个论点讲了三次。视频控制的每条轴都曾有一个”标准中间表示”(相机的位姿矩阵或文字、身体的姿态骨架、音频的整段双向解码),每个中间表示存在的理由都是让监督或推理变得可行。三篇论文各自证明:中间表示造成的损失,已经大于它换来可行性所值,于是都用一条从数据自身算出的信号替换它:由参数估计渲染出的相机网格、原始驱动像素加可学习掩码、蒸馏出的因果轨迹。三者中还有两篇共享第二个动作,用无标注视频自监督(OmniDirector 的 180 万条网络视频,SCAIL-2 从真人数据集反推出的合成对),绕开配对数据采集;Lip Forcing 则干脆继承教师的监督,不采新数据。
差异同样值得看清。OmniDirector 的瓶颈在时间(480p 短片);SCAIL-2 的瓶颈在数据质量(精度被生成器封顶,对口型明确不做);Lip Forcing 的瓶颈在保真-速度前沿(自己选checkpoint)。上表不是受控对比(基准、底座、评测集全不同),本页结论框建立在各轴各自的数字上,而不是跨轴排名。
局限与存疑:数字不能证明什么
三条警示对三篇同时成立。第一,评测管线可能偏袒自己:OmniDirector 训练和打分都用 DPA-V3 相机估计器;Lip Forcing 的 Sync-C 是基于 SyncNet 的指标,老 GAN 方法会刷分(Wav2Lip 的 8.56);SCAIL-2 最强的数字需要外接网格提取器。第二,头条指标不是部署指标:96.52% 的时序精度衡量的是 3 帧内的切镜时机,不是跨镜头的电影级连贯;31.58 FPS 属于同步最弱的那个点;FVD 的优势依赖网格配对。第三,三者都还没放出完整可复现的栈:OmniDirector 的数据与权重未确认,SCAIL-2 承诺放子集,Lip Forcing 的两步调度绑定它自己的教师和数据集。
怎么选:什么时候用哪个
- 要指定运镜,尤其带切镜的多镜头剪辑:OmniDirector。2.64° vs 4.11° 的旋转误差是常规优势,96.52% vs 2.20% 的多镜头时序精度才是采用它的理由。要分钟级高清长序列就再等等。
- 跑姿态驱动动画、在骨架一步丢失细节:SCAIL-2 可复现的思路(原始驱动 token 加上下文掩码)能装在现成的 Wan2.1-14B I2V 底座上,但要先备好 64 张 H100 一周的微调预算和整套合成数据管线。
- 要直播级流式数字人:Lip Forcing,按你的取舍选点:1.3B 换 31.58 FPS,14B 换 Sync-C 7.59、15.11 FPS。如果只看同步分数,Wav2Lip 仍更便宜。
- 三条轴全都要:目前没有一个模型统一三者。SCAIL-2 明确把对口型与表情留作未来工作,相机+身体+嘴唇的统一控制仍是开放问题。
常见问题
可控视频生成哪个方法最好?
没有跨轴排名:OmniDirector(相机)、SCAIL-2(角色动画)、Lip Forcing(对口型)在不同基准上对不同基线评测。在各自轴上,三篇都明显胜过前任:OmniDirector 旋转误差 2.64° vs 4.11°,SCAIL-2 FVD 287.11 vs 305.31,Lip Forcing 31.58 FPS vs 3.23。
这些方法需要配对训练数据吗?
OmniDirector 不需要跨配对相机数据——网格从视频自身渲染,每条视频自成训练对。SCAIL-2 需要(参考图、驱动视频)配对数据,靠智能体管线合成(MotionPair-60K)。Lip Forcing 不需要新数据,直接蒸馏已有的 14B 双向教师。
实时对口型的速度取舍是什么?
在 33 条 HDTF 上,Lip Forcing 的 1.3B 学生流式跑到 31.58 FPS,但 Sync-C 只有 6.88(真值 7.95,LatentSync 8.10);14B 学生 Sync-C 7.59、15.11 FPS。所以”实时”和”同步最好”是同一个模型的两个不同 checkpoint。
为什么 96.52% 的多镜头数字是 OmniDirector 的头条?
因为此前的相机控制方法基本无法复现镜头转场:CamCloneMaster 时序精度 2.20%,LTX-LoRA 38.94%;OmniDirector 把转场帧渲染成纯白、分别生成镜头间与镜头内的相机提示词,做到 96.52%。要注意:该指标是 480p 下”3 帧内切对位置”的度量,不是长程连贯性。
能不能一个模型同时控制相机、身体和嘴唇?
按这三篇论文看不能。SCAIL-2 明确不做对口型和表情,OmniDirector 只管相机,Lip Forcing 只做视频到视频的对口型。三轴统一仍是开放问题。