
Echo-Infinity 对比 MIGA:无限长视频生成的两条路线
Echo-Infinity 学一个固定大小记忆:24 小时超 130 万帧、H100 上 18.5 FPS;MIGA 免训练只改采样器,VBench 97.82、1000+ 帧恒定显存。
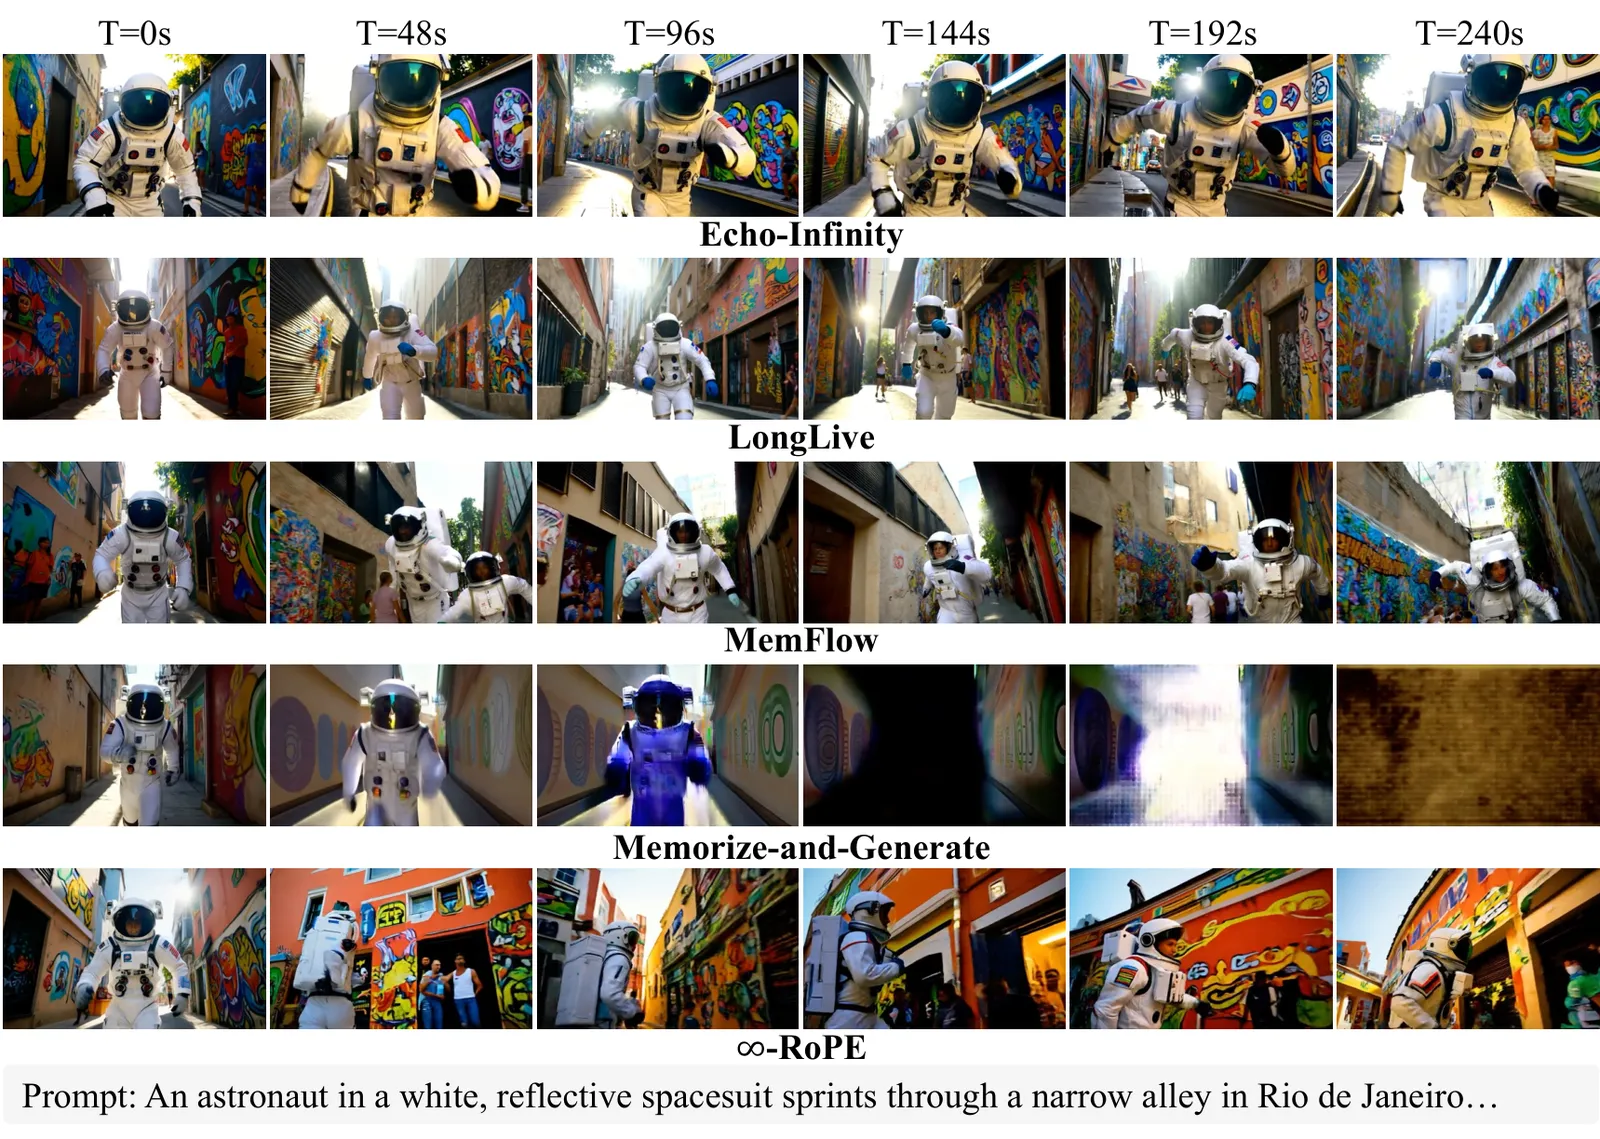
共同的问题:视频会忘了自己从哪出发
每个自回归视频模型都在短片段上训练,滚过训练长度后无一幸免:主体变形、背景漂移、物理规律悄悄改主意。本页对比的两篇论文从成本谱系的两端解决这个问题,放在一起读才有意义。Echo-Infinity 一次性付出训练成本,学「该记什么」;MIGA 训练成本为零,改的是采样器,让一个冻结的短视频模型直接流出 1000 帧以上。
它们回答的也是两个不同的运营问题。Echo-Infinity 面向交互:模型边跑边接收动作或新提示,必须以人能玩的帧率保持数小时的连贯。MIGA 面向成片长度:把你现有的视频扩散模型拉长,不重训。两者都宣称「恒定显存」,都报了 VBench 家族的分数,但数字落在不同的基座和不同的评测 regime 上。下面讲清楚什么才真正可比。
两者各自的原理
Echo-Infinity:学出来的固定大小记忆。 自回归视频扩散模型要 attend 历史,而历史无限增长。此前的无限视频方法用固定规则裁剪历史:KV 缓存窗口、固定压缩比、推理时拉伸 RoPE。Echo-Infinity 用一小组可学习的 Memory Query token 替换规则:一帧离开局部注意力窗口时,它的信息经注意力加门控折进这些 query,query 因此携带至今全部内容的压缩摘要,并随扩散 Transformer 端到端训练。记忆是定长 token 集,所以任意长度下每帧计算量恒定,且由模型自己学哪些历史该过滤、抽象、压缩。配套的 Unified Relative RoPE Recipe 锚定 sink 帧、把帧号增长压在基座预训练的最大位置 id 以内,消除了自回归滚动最常会撞上的 RoPE 外推失败。
MIGA:对齐冻结模型所见分布的采样器。 FIFO-Diffusion 这类滑窗采样器本来就能免训练地流出长视频:对一个噪声级别交错的帧队列做去噪。坑在训练与推理的错位:基座模型训练时见到的帧共享同一噪声级别,滑窗喂给它的是混合分布,质量随之退化、画面漂移。MIGA 加两个免训练机制:两阶段训练-推理对齐先在窄窗口(论文最优宽度 4 帧)内做之字形迭代去噪,把各帧拉向共享噪声级别,再做统一噪声级别去噪,对齐训练分布;双重一致性增强加入自反思步骤,让模型在采样中复查并修正自己的预测,外加长程帧引导(最优 6 帧)把新帧锚到早期内容上。全程不动权重,所以能跨基座迁移。
关键数字
| 测量项 | Echo-Infinity | MIGA | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 头部分数 | VBench 总分 85.35(5 秒);VBench-Long 30 秒 85.61 | VBench 总分 97.82(128 帧) | 基座、片长、VBench 版本全不同 | 否 |
| 长程质量 | VBench-Long 240 秒 82.01;语义 59.53 | NarrLV 场景 79.32 / 目标属性 67.87 / 目标动作 67.94(Wan2.1-1.3B) | 长程 regime,基准不同 | 否 |
| 一致性 | (未单列) | 主体 97.66、背景 96.99;对 FIFO 各 +4.7%、+2.0% | MIGA 自己的 VBench 轮次 | 是,MIGA 内部 |
| 速度 | 单卡 H100 18.5 FPS | 非卖点;采样器每帧增加之字形、自反思、引导计算 | Echo 对同类记忆方法 | 部分 |
| 速度参照 | LongLive 20.7、MemFlow 18.7、Memorize-and-Generate 21.7 FPS | 不适用 | 竞品与 Echo 只差几 FPS | 是,Echo 内部 |
| 演示最大长度 | 24 小时实时滚动超 130 万帧 | 1000+ 帧 | 稳定性演示对实际成片长度 | 否 |
| 显存增长 | 定长 Memory Query,每帧计算恒定 | 滑窗恒定显存 | 两者都宣称恒定 | 是,各自成立 |
| 内部消融 | (页面未报) | 仅 TTA +2.03、仅 DCE +1.73 总分 | MIGA 消融,两半都承重 | 是,MIGA 内部 |
| 展示的基座 | 一个 AR 视频 DiT 家族 | VideoCrafter2(16 latents)、Wan2.1-1.3B(21 latents) | MIGA 展示了跨基座迁移 | 不适用 |
前两行先读缺什么。MIGA 的 97.82 和 Echo-Infinity 的 85.35 都是「VBench」,很容易读成 97.82 更好。两者不可比:MIGA 的分数来自 128 帧 VideoCrafter2 生成、用标准 VBench 套评测,其中一致性子项对所有方法本来就都在 95 分以上;Echo 的 85.35 是 5 秒短片分数,真正属于本页主题的数是 240 秒的 VBench-Long 82.01。一个在 128 帧拿 97.82 的模型并不「领先」于在 240 秒守住 82.01 的模型,两个数描述的是离起始帧不同的距离。跨论文诚实的主张要窄得多:两者都比各自的无干预基线更久地守住了质量,且各自在自己的评测套内证明了这一点。
两篇论文各自真正的主张
来自 Echo-Infinity 的主张关于持续滚动。24 小时、130 万帧的演示是稳定性与吞吐量的结果,论文自称首次;速度故事刻意谦虚:H100 上 18.5 FPS 与 LongLive(20.7)、MemFlow(18.7)、Memorize-and-Generate(21.7)同一区间。差异点在于可学习记忆让 VBench-Long 在 240 秒仍保持 82.01,而固定调度缓存会漂移。论文自己的长程语义分是诚实的保留:240 秒 59.53 对 5 秒 81.49,视觉质量守得比语义久。
来自 MIGA 的主张关于入场成本。它不是训练更好的视频模型,而是让你现有的模型在恒定显存下流到 1000 帧以上不崩:对 FIFO-Diffusion 的 VBench 提升约 2.8 分(97.82 对 95.02),对 FreeLong 不到 1 分(96.95)。消融是诚信检查:仅 TTA +2.03、仅 DCE +1.73,方法的两半都在承重。Wan2.1-1.3B 上的 NarrLV(67.87 目标属性、67.94 目标动作)是诚实的保留:画面稳了,叙事语义仍停在 60 大几。
怎么选
- 已有好用的短视频检查点、只要更长的成片:MIGA 是更便宜的路径。不重训、不新增权重,至少跨两个基座家族可迁移,一致性收益(对 FIFO 主体 +4.7%、背景 +2.0%)来自可独立开关的采样器改动。
- **要实时交互、不只是一个长文件:**Echo-Infinity 为此而生:单卡 H100 18.5 FPS、每帧计算恒定,论文还在 60 秒交互 regime 下评测(质量 81.71、CLIP 34.10)。这是游戏、仿真器、具身滚动需要的画像。
- **完全不能训练:**两者里只有 MIGA 可选;Echo-Infinity 的记忆 query 是随骨干端到端训出来的。
- **关心一分钟之后发生什么:**两篇都没解决语义。Echo 自己的语义分从 5 秒 81.49 掉到 240 秒 59.53,MIGA 的叙事属性分停在 60 大几。用例需要长程故事连贯时,要给回访式评测留预算,不能只看 VBench。
- **选型轴上还有流式这一维:**如果真实约束是直播流式每段延迟而非总长度,Stream-T1 这类测试时扩展方法是值得先基准测试的相邻选项,再决定是否上无限长设计。
局限与存疑
没有人把这两种方法放进同一套 harness,所以「学出来的记忆对免训练对齐」还没有共享基准答案。Echo-Infinity 的数字来自单一家族的骨干,学出来的压缩在硬切镜或分布外场景变化、超长滚动下没有表征;它的 24 小时主张证明的是吞吐与稳定,不是小时级语义连贯,而 VBench 家族根本不测这个。MIGA 继承基座模型的全部弱点,且每帧增加采样器计算,「恒定显存」不等于免费:之字形去噪、自反思、引导帧的 wall-clock 成本不是论文卖点,部署前值得实测。两篇都在各自的基座、各自的分辨率上评测,上面这张表的每一行才都标了可比性。两篇留下的是同一个开放问题:什么记忆设计能让语义(不只是像素)在小时级尺度上稳定,两篇论文里的基准都答不了。
常见问题
两篇的 VBench 分数能直接对比吗?
不能。MIGA 的 97.82 是 128 帧 VideoCrafter2 生成在标准 VBench 套上的得分,其中一致性子项对所有方法本就在 95 分以上;Echo-Infinity 的 85.35 是 5 秒分数,其长程对应值是 240 秒 VBench-Long 的 82.01。基座、片长、套件版本全不同,两个数描述的是不同 regime,不是排名。
哪种方法生成的视频更长?
按演示规模是 Echo-Infinity:24 小时实时滚动超 130 万帧。MIGA 演示到 1000+ 帧,已覆盖多数实际长片需求。两个演示的含义也不同:Echo 证明实时交互下的稳定性,MIGA 证明冻结的短视频模型可以被推过训练长度而不重训。
Echo-Infinity 如何让每帧成本保持恒定?
靠一小组定长的可学习 Memory Query token。帧被淘汰时经注意力加门控折入 query,历史是被摘要而不是被存储,每帧计算量不随片长增长。配套的 Unified Relative RoPE Recipe 把帧号增长压在基座预训练的最大位置 id 以内,避免外推失败。
MIGA 需要任何训练或微调吗?
不需要。它纯是采样时干预:两阶段训练-推理对齐加双重一致性增强,不动任何权重。所以它能跨 VideoCrafter2、Wan2.1-1.3B 等基座迁移,消融(仅 TTA +2.03、仅 DCE +1.73)也能各自独立开关。
什么情况下该选流式方法而不是这两者?
如果约束是直播流式每段延迟而不是总长度,流式测试时扩展这一相邻家族更值得先 benchmark。无限长记忆和每段速度是两个相关但独立的问题,一个轴上的强项说明不了另一个轴。