
流式音频模型对比:低延迟生成、主动开口,与拆穿「假装在听」的测试
三篇论文各答「实时音频 AI」一面:SwanSphere 首块 0.21 秒生成空间音频,Audio Interaction Model 学会何时开口,THUD 抓出只读唇的模型。
「实时音频」其实藏着三件差很远的事
2026 年说「流式音频模型」,至少在指三件互不引用的事。SwanSphere 是生成者:它生成四通道一阶环绕声(FOA),与视频或文本提示同步,第一块音频 0.21 秒就出来,而不是等整段渲染完。Audio Interaction Model 是对话者:一个持续倾听的音频大模型,对「要不要回、何时回」做语义决策,而不是傻等静音计时器。《当视觉替声音作答》 两者都不是,它是测谎器:证明那些拿「音频理解」做卖点的视频模型大多只是在读画面,并给出探针和廉价修复。
共同的主线是广义的延迟:不只是毫秒,而是「信息已经存在」到「模型据此行动」之间的那段空窗。一个必须等整段素材的生成器、一个必须等干净轮次边界的听者、一个不用碰音频流就能通过的基准,是同一个失败换了三件衣服。
关键数字
| 维度 | SwanSphere | Audio Interaction Model | THUD(当视觉替声音作答) |
|---|---|---|---|
| 干什么 | 流式空间音频生成 | 流式音频大模型(感知-决策-响应) | 音频 grounding 探针 + 训练修复 |
| 首次响应延迟 | 首块 0.21 秒(整段 9.13 秒) | 未公布 | 不适用 |
| 模型规模 | 1.09B 参数 | 未披露 | 修复基于 Qwen3-Omni-30B 骨干 |
| 训练数据 | 约 16.5 万对视频-音频(约 458 小时)+ 约 100 万伪 FOA 课程样本 | StreamAudio-2M:约 260 万条、7 项能力、28 个子任务 | 约 1 万样本的两阶段修复 |
| 头条质量指标 | 视频到空间音频 FD 120.28,OmniAudio 157.67 | 8 个基准「有竞争力」,无逐基准分数 | 修复前静音片段音频幻觉超 63% |
| 定位指标 | SELD 加权余弦 0.63 对 OmniAudio 0.41;角度误差 1.03° 对 1.27° | Proactive-Sound-Bench(同作者新基准) | Shift 34.3% → 83.1%;VGGSync 36.8% → 56.4% |
| 主观听感 | MOS-SQ 4.32 / MOS-AF 4.44,真值 4.60 / 4.58 | 不适用 | 不适用 |
| 修复的代价 | 字幕多描述单一主声源,多声源受限 | 主动性结论缺外部验证 | Video-MME 70.1%、LVBench 52.1%、WorldSense 50.3% 保持稳定 |
读这张表,缺口和数字同样重要。三篇里只有 SwanSphere 公布了延迟和逐指标分数;Audio Interaction Model 刻意报广度(8 个基准、260 万条语料)而非深度,作者自己称其为进行中工作;THUD 的数字讲的是别家模型的失败,不是可下载的产品。三者成熟度不同,这恰恰意味着它们回答的是不同的采购问题。
SwanSphere:把生成的首块延迟做到交互级
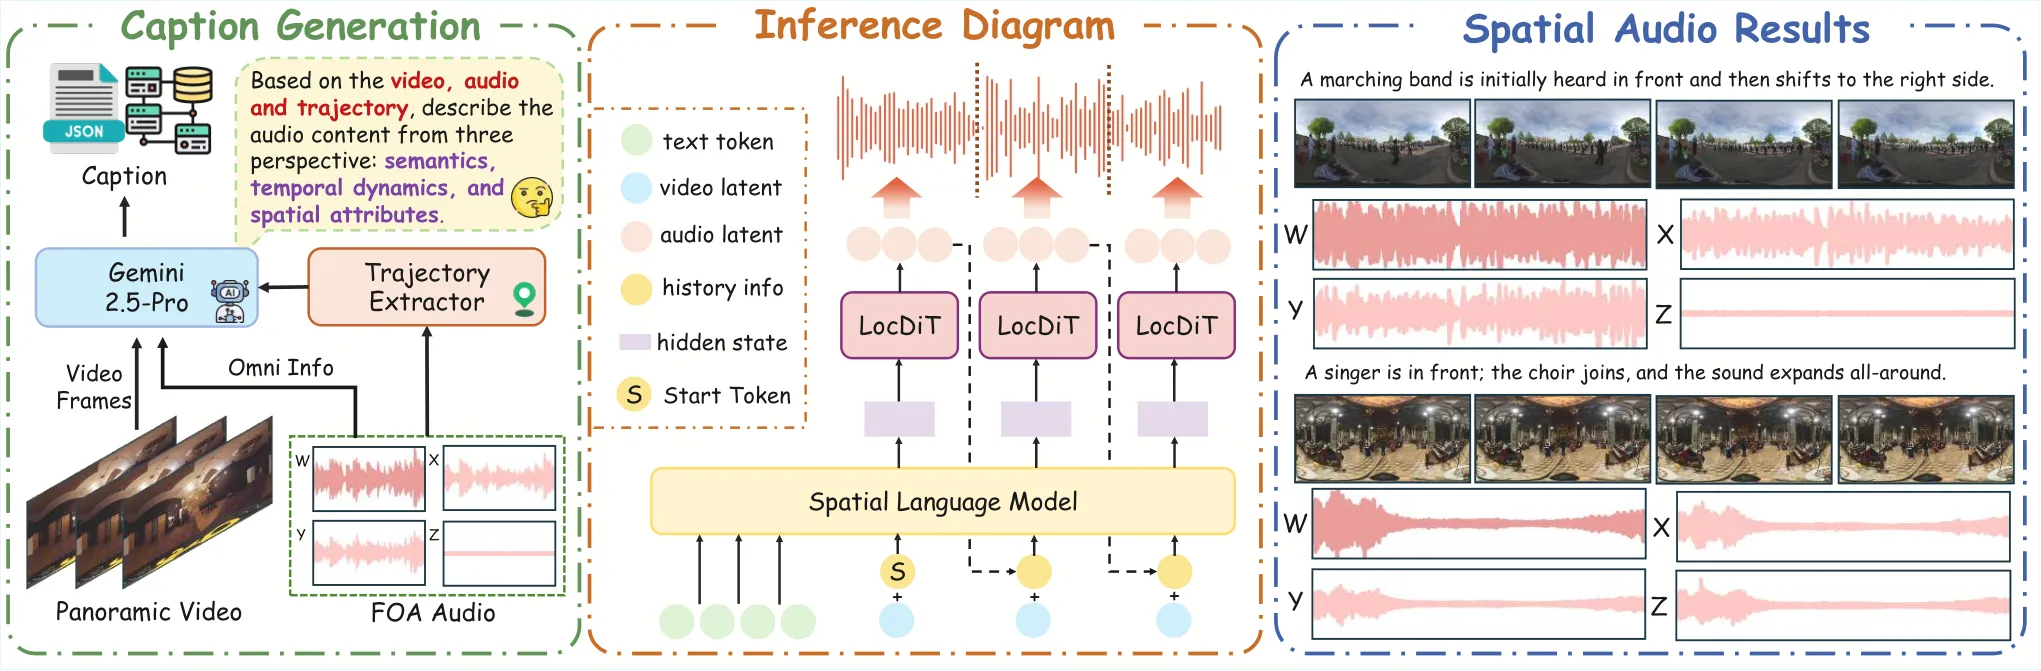
SwanSphere 的贡献一半在架构一半在训练。架构上,流水线拆成两段:空间语言模型从视频特征或文本自回归地预测语义嵌入(这是让流式成为可能的因果部分);再由局部扩散 Transformer(LocDiT)通过流匹配,在专为环绕声设计的 4 通道 FOA-VAE 隐空间里把嵌入解码成连续波形。训练上真正出力的是两个设计:SVAC 对比学习把画面运动和音频方向对齐,让「车向左划,声音就从左边来」成为学到的规律;多目标在线 DPO 同时在保真度、空间准确度、同步性上做偏好优化,而不是只盯单一奖励。
对搭建者最重要的数字是延迟和定位这一对。首块 0.21 秒是真交互级(数字人直播、AR、游戏音频都因此可行),而且不是靠质量崩塌换来的:视频到空间音频 FD 120.28,OmniAudio 157.67;KL 1.36 对 1.93;角度误差 1.03° 对 1.27°;最直接的「声音方位对不对」探针 SELD 加权余弦相似度 0.63 对 0.41。文本驱动变体保持同样差距(FD 142.80 对 174.13),说明领先不是视频条件的产物。人类评分也接近真值(MOS-SQ 4.32、MOS-AF 4.44 对 4.60、4.58)。
论文自己坦承的边界:空间字幕大多只描述单一主导声源,多声源场景(乐器分散各方向的交响音乐会)建模不足;大量训练信号来自普通音频的伪 FOA 转换,而非实测环绕声;5% 留出测试集是同分布的,域外泛化未经验证。
Audio Interaction Model:把「何时开口」变成可学习的决策
Audio Interaction Model 攻击的是另一种延迟:社交延迟。多数音频大模型跑的是干净的离线交易:收到一段完整音频,转写,回复。这逼迫它们等到音频结束,也彻底抹掉了主动性的概念。本文在循环里插入了一个显式决策阶段:声音流入的同时,模型持续感知声学场景和指令,对「信息够不够动手、现在是不是时机」做语义判断,然后才决定是否进入生成。这个决策由内容驱动而非固定静音阈值,同一个模型因此既能保持沉默、被点名时作答,也能在环境出现值得回应的事件时主动介入。
循环之外的工程占了另一半贡献。SoundFlow 覆盖三件事:流式原生数据构建(用实时流形态的输入训练)、理解感知式训练、异步推理(边说边继续听)。数据底座 StreamAudio-2M 约 260 万条、横跨 7 项核心能力和 28 个子任务(对话、实时转写、指令跟随、环境声反应),「单一统一模型」之所以可行,靠的正是这个广度。作者还提出了 Proactive-Sound-Bench 来测主动音频介入,这是轮次式基准压根不测的部分。
诚实的读法,论文自己也支持:摘要声称的是 8 个基准上「有竞争力」,而非 state of the art,且没有公布延迟数字或逐基准分数,你算不出流式设计相对离线模型究竟付出了多少、又拿回了多少。主动介入是双刃剑:会不请自答的模型也可能在错误时机插话;而 Proactive-Sound-Bench 出自同一批作者,主动性结论仍待外部验证。把这篇当作「配方和语料比单个分数更重要」的方向来读,在权重放出之前别押注迁移。
THUD:给「我们懂音频」做静音测试
第三篇论文解释了为什么对上面两者,以及每个「会用音频」的 demo,都要保持怀疑。它的发现是音视频版的聪明汉斯效应:把音轨静音后,头部模型仍有超过 63% 的概率声称听到了声音,因为它们在读画面。这条捷径同时出现在开源模型(Qwen3-Omni、MiniCPM-o、Ming-flash-omni)和 Gemini、GPT 一类闭源系统里,这意味着标准音视频基准一直在给读唇术打分。
THUD 的解法方法论上是廉价的、可直接照抄的:保持视频不动,只用三种反事实编辑音频:Shift(时间错位,测同步察觉)、Mute(静音,测声音缺席察觉)、Swap(换不匹配音轨,测跨模态一致性)。依赖画面的模型在音频问题上只能瞎猜,而这正是论文观察到的结果。修复配方是在干预衍生数据上做 SFT,再混入通用视频偏好做 DPO,基于 Qwen3-Omni-30B,全程约 1 万样本。结果:三个 THUD 维度平均提升 28 个百分点,其中 Shift 涨幅最大(34.3% → 83.1%),分布外的 VGGSync 也有提升(36.8% → 56.4%),通用视频成绩保持稳定(Video-MME 70.1%、LVBench 52.1%、WorldSense 50.3%、DailyOmni 67.9%)。
论文自己的两条告诫应该跟着这个数字一起传播。28 分是三个维度的平均,画像并不均衡:时序同步最容易用配对数据教会,而更难的 Mute 和 Swap(声音存在检测与跨模态一致性)涨得少。且修复只在单一开源骨干上验证过;被诊断的闭源模型,外人修不了。
怎么选
- **你在做数字人直播、AR 或游戏音频,需要声音即时出来:**三篇里只有 SwanSphere 有实测的交互级延迟和逐指标质量分。它的约束(单一主声源、伪 FOA 训练数据)划出了它不亮的区域。
- **你在做语音助手,难点是交互手感而非识别准确率:**感知-决策-响应循环是正确的抽象,StreamAudio-2M 是流式原生音频训练数据上最大的公开押注。但要为「未验证」留预算:延迟和逐基准数字都没公开。
- **你在评测或采购任何号称音频理解的模型:**先跑 THUD。静音后重问只需五分钟,已经抓到过旗舰模型;1 万样本的修复证明缺口可补,所以静音测试挂了应该触发一场数据对话,而不是直接出局。
更深一层的要点是:这三项工作可以组合。一个 0.21 秒生成空间音频、语义化决定何时开口、并用反事实音频探针验证过的系统,和在脚本化片段上 demo 漂亮的系统,是完全不同的产品;而上面这些 2026 年的数字,是目前每一项最硬的公开证据。
局限与存疑
三篇论文共享同一个盲区:没有任何一篇测量「组合态」。SwanSphere 的延迟没在实时对话循环里测过;Audio Interaction Model 的接话时机没配着生成空间音频测过;THUD 的探针针对的是视频理解模型,没打在音频生成器或音频大模型上,所以我们不知道一个流式听者有没有它自己的聪明汉斯问题。把 THUD 式反事实探针搬到生成器和对话听者身上,是最显然的开放实验。另一个开放问题是数据真实性:SwanSphere 靠伪 FOA 转换,Audio Interaction Model 的语料新而广,THUD 的反事实刻意合成,而真实声学环境比三者都更脏。
常见问题
「流式音频模型」到底指什么,如何区分三类?
2026 年的用法至少有三义:逐块输出音频而非整段渲染的生成器(SwanSphere,首块 0.21 秒);持续处理声音并自行决定何时响应的听者(Audio Interaction Model 的感知-决策-响应循环);以及检验音频是否真被用上的验证方法(THUD 的反事实探针)。本页三者都对比。
三篇论文的延迟与质量结果对比如何?
唯一公布的首次响应延迟是 SwanSphere 的首块 0.21 秒,整段生成 9.13 秒。质量侧也只有 SwanSphere 放出逐指标分数:FD 120.28 对 OmniAudio 157.67,KL 1.36 对 1.93,角度误差 1.03° 对 1.27°,SELD 余弦 0.63 对 0.41。Audio Interaction Model 只报 8 个基准上「有竞争力」,没有逐基准数字,目前公开数据排不出听侧名次。
怎么测试视频模型是不是真在用音频?
静音后重问。THUD 研究中,模型在超过 63% 的静音片段上仍声称听到了声音,视觉走捷径暴露无遗。完整协议再加 Shift(音频时间错位)和 Swap(换不匹配音轨);1 万样本的修复把探针平均分拉高 28 分,所以静音测试挂了点向的是训练数据缺口,不是死路。
Audio Interaction Model 的主动开口方法是怎么实现的?
能,这正是它的核心设计。感知与生成之间有一个语义决策段:模型对「信息够不够动手、现在是不是时机」做判断,然后才进入生成,取代传统语音接口的固定静音计时器。工程上靠 SoundFlow 三根支柱支撑:流式原生数据构建、理解感知式训练、异步推理(边说边继续听);训练底座是约 260 万条的 StreamAudio-2M 语料。需要注意:测量这一能力的 Proactive-Sound-Bench 出自同一批作者,独立验证仍待进行。