
高效 AI · Transformer · 语言模型
Test-Time Training 对比 Sleep:让模型在训练之外学习的两条路
SD3.5-T5 用 TTT 层约 1 小时把 Softmax 线性化、提速 1.32-1.47 倍;Sleep 证明逐 token 测试时训练只有 10%,主张离线巩固做到 80%。
一个名字,两件完全不同的事
在 2026 年搜 “test-time training”,会撞上两篇几乎不相干的论文。一篇是架构论文:用 TTT 线性化 ViT。这里的 TTT 是一个层结构,每次前向传播在层内对一个小模型做一步梯度更新,从而把预训练的 Softmax transformer 转换成线性注意力模型。另一篇是记忆论文:大模型需要睡眠,“test-time training” 在文中只是被击败的基线,在 ARC 小样本任务上只有 10%;真正的主张是推理时干脆不学习,把学习挪到会话之间的离线”睡眠”阶段。
两篇论文挠的是同一个痒处:训练结束了,部署开始了,模型还得继续适应。分歧只在什么时候学、在哪里学。放在一起读,才能回答真正的问题:不是”TTT 是什么”,而是”我到底要哪种训练后学习”。
一边:TTT 作为架构(SD3.5-T5)
SD3.5-T5 要解决的是成本,不是记忆。线性注意力去掉了高分辨率扩散模型最贵的二次项,但从零训一个线性模型和原模型一样贵。人人都想走的捷径是继承预训练权重再短暂微调,而这条捷径一直失败:论文的 ImageNet 探针里,从 DeiT 微调 plain 线性注意力只有 63.30% Top-1,LiT 式嫁接 69.52%,CLEAR 68.66%,Hedgehog 直接 NaN 发散,对照 Softmax DeiT-Tiny 的 72.05%。
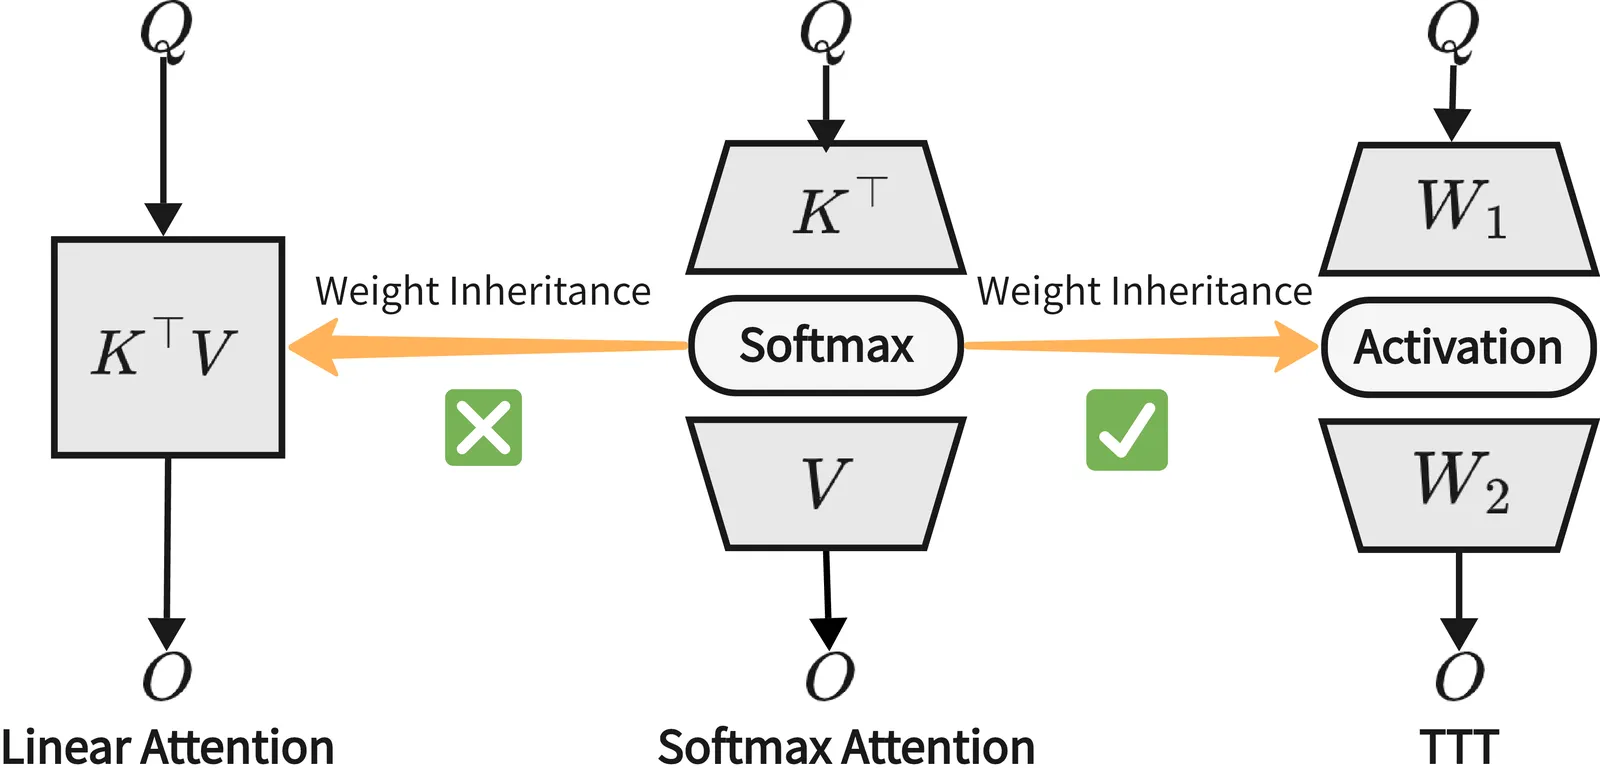
解法不是更聪明的核函数,而是结构对齐。Softmax 注意力可以改写成两层变换:query 先过一个由 key 拼成的矩阵,中间过非线性,再过由 value 拼成的矩阵。TTT 层恰好也是这个形状:内部模型是一个两层 MLP,第一层在推理时做一步梯度调整,读作 query、非线性中段、输出。两项结构逐项对齐,预训练的 Q/K/V/O 投影就能原样插进去。消融把话说死了:DiT-S/2 上完整继承 FID 68.52,只继承 MLP 是 89.71,只继承注意力是 93.18,可迁移的知识就长在注意力权重里。
两个补丁让继承可训练。预训练 key 带着很大的常数偏移(5K 个 ViT 激活上测得偏移比约 0.5,随机初始化只有 0.07),Softmax 会抵消它而 TTT 不会,不做 key 实例归一化内部优化就直接爆;光这一处改动,就是从 NaN 到 DeiT-Tiny 71.19% 的距离。再加一个轻量局部性模块(query/key 上的深度卷积加邻域注意力项),升到 72.06%,反超 72.05% 的 Softmax 基线。完整数字表见下文「关键数字」。
另一边:Sleep,以及测试时训练输在哪(谷歌)
Sleep 论文要解决的是记忆,不是速度。处理长对话的模型只把新事实存在激活和上下文窗口里,不写回权重,下个会话从零开始。作者把上下文内学习称为”选择性、依赖检索的”,然后提出两阶段离线配方。巩固(Consolidation) 用向上蒸馏把近期上下文蒸馏进网络:吸收了上下文的小模型去教更大的模型,结合广义知识蒸馏和基于 RL 的模仿学习,并扩充参数量给新知识腾地方。做梦(Dreaming) 负责自我改进:模型自造合成练习数据,按梯度重要性给候选”梦境”打分,在无人工标注下自我提升。两个阶段刻意分开,因为在一个循环里反复自我修改”可能造成灾难性遗忘”。
关键数字
SD3.5-T5(TTT 层转换)
| 结果 | SD3.5-T5(线性化) | 对照基线 |
|---|---|---|
| GenEval 总分(SD3.5) | 0.69 | 微调版 Softmax 0.70,原版 SD3.5 0.66 |
| DPG-Bench(SD3.5) | 84.43 | 原版 SD3.5-Medium 83.83 |
| 推理延迟 1024x1024(单张 H20) | 19s(1.32 倍) | 25s |
| 推理延迟 2048x2048 | 提速 1.47 倍 | 二次项在 2K 占主导 |
| 转换成本 | 3000 步、batch 64、4 张 H20 约 1 小时 | DiT 从零训要 1400 epoch |
| DiT5-XL/2 转换后 FID | 2.48 | 原版 2.27,只用了 0.57% 的训练量 |
| DeiT-Tiny 转换后 Top-1 | 71.19%(加局部性 72.06%) | Softmax 72.05%;plain 线性 63.30% |
诚实的读法是:质量是噪声内的持平,不是超越;加速受分辨率门控,1K 以下没有二次项可省,甚至可能更慢。站得住的主张是转换经济学:约一小时的微调,换来不扔预训练模型的高分辨率提速。
Sleep(离线巩固加做梦)
| 基准 | Sleep | 它击败的基线 |
|---|---|---|
| ARC 小样本 | 成功率 80% | SEAL 72.5%,测试时训练 10%,上下文内学习 0% |
| AIME-24(Qwen3-8B) | 79.2% | 比 OPSD 基线高 +2.6% |
| AIME-25 / HMMT-25(Qwen3-8B) | 69.0% / 46.1% | 1.7B 模型为 53.2% / 40.2% / 29.3% |
| SQuAD 知识吸收 | 单段 48.9%,n=200 段 46.2% | SEAL 46.7% / 43.2% |
| BABILong 长上下文检索 | 10M token 近乎满分 | Titans、ARMT 超出 1M 后急剧退化 |
两个读法很关键。其一,论文自己的表就是迄今对朴素测试时训练最清晰的判决书:在它瞄准的持久小样本学习能力上,逐 token TTT 只有 10%,而对上下文内学习的 0% 也几乎算不上赢。其二,最强的长上下文成绩建立在一个叫 Hope 的多频记忆架构之上(不同参数组以不同速率跨睡眠周期更新),睡眠日程和底层架构各贡献多少还没拆干净;+2.6% 的 AIME-24 优势真实但偏窄,且论文没报一次睡眠周期的算力开销,部署间隙跑这个是否现实仍未验证。
跨论文对照
| 维度 | TTT 层(SD3.5-T5) | Sleep(巩固加做梦) |
|---|---|---|
| 这里的”测试时”指什么 | 每次前向:层内一步梯度 | 推理时什么都不发生,学习在会话之间离线做 |
| 更新什么 | 层内小模型,逐 token | 全网络权重,每轮睡眠 |
| 学完之后留下什么 | 什么都不留,每条序列重置 | 跨会话的持久参数记忆 |
| 一次性 setup 成本 | 3000 步、4 张 H20 约 1 小时 | 未报告(巩固加做梦多轮) |
| 推理期额外开销 | 1K-2K 下比 Softmax 更低(1.32-1.47 倍提速) | 推理与基座相同 |
| 代表性质差 | GenEval 0.69 对微调 Softmax 0.70;DeiT 72.06% 对 72.05% | ARC 80% 对 SEAL 72.5%、TTT 10%;AIME-24 79.2% |
| 主要翻车点 | key 未居中即 NaN;质量只能持平 | 两阶段合并即灾难性遗忘;睡眠成本未报告 |
| 替代的旧方案 | 从零重训线性注意力 | 上下文内学习、SEAL 式自编辑 |
分歧被这张表说透了:SD3.5-T5 在推理时学习,但序列之间全部遗忘;Sleep 拒绝在推理时学习,整个设计围绕会话之间保住东西。TTT 这个统称把两件近乎互补的设计藏在了同一个词下面。理论上两者并不冲突:TTT 层的逐 token 适配又便宜又不持久,恰恰是 Sleep 框架里”醒着”阶段该有的那种学习,一个会睡眠的模型内部完全可以装 TTT 层。
怎么选
机制对齐瓶颈。如果瓶颈是手里已有模型在高分辨率下的推理 FLOPs,而且是一个 Softmax transformer,TTT 层转换是少见的带着完整继承故事和明码标价的效率方案:3000 步、GenEval 噪声内持平、1K/2K 提速 1.32 到 1.47 倍。如果瓶颈是上下文窗口一关模型就把学到的一切清零,已发表的证据说逐 token 测试时训练不是答案,真正能把记忆写进权重的是离线的巩固加做梦循环。如果你在评估”推理时学习”的主张,先问清对方指的是哪一种,因为 SD3.5-T5 和 Sleep 的数字,和两者之间的任何东西都不可比。
局限与存疑
两篇论文都没补上自己最大的窟窿。SD3.5-T5 没给 SD3.5 的直接 FID,只靠 GenEval 和 DPG-Bench,且微调数据是 Flux 生成的合成图,持平里有多少来自蒸馏 Flux 而非保留 SD3.5 仍未可知;TTT 参数还要 20 倍学习率乘数,换骨干网络大概率得重调。Sleep 没报一次睡眠周期的算力和耗时,AIME-24 的 +2.6% 优势偏窄,在自造数据上反复做梦会不会随周期漂移,正是论文自己点出的最重要开放问题。两篇也都只测了自己的体制:没有线性化的文本或视频 transformer,也没有在别人设计的架构上跑睡眠周期。
常见问题
test-time training 到底是什么?
看你读哪篇 2026 年的论文。架构文献里,TTT 层在每次前向中对内部小模型做一步梯度,以线性复杂度获得注意力式行为,SD3.5-T5 用它转换预训练 Softmax transformer。持续学习文献里,“test-time training” 指服务期间改动模型权重,大模型需要睡眠 把这个基线测到 ARC 小样本 10%,并主张把学习挪到离线。
测试时训练会在推理时更新模型权重吗?
只有 TTT 层的微小内部模型,且只在单条序列内更新,每次前向后即丢弃。Sleep 立场相反:推理时一概不更新,所有学习发生在离线的巩固加做梦阶段,把持久改动写进权重。
为什么早期把 Softmax 转成线性注意力的方法会失败?
因为固定的线性核表征不了 Softmax 学到的东西。LiT 式嫁接只留 MLP 权重(DeiT-Tiny 69.52% 对 Softmax 72.05%),plain 线性 63.30%,Hedgehog 直接 NaN。TTT 层能成,是因为它的两层内部模型和 Softmax 注意力结构同形,预训练 Q/K/V/O 投影带着原义迁移,做到 71.19%,加局部性模块 72.06%。
SD3.5-T5 的转换方法有多便宜?
batch 64、Flux 生成 1024x1024 图像上微调 3000 步,4 张 H20 约 1 小时。类条件 DiT 同样配方只需 8 个 epoch,对照从零训练的 1400 epoch,约 0.57% 的训练量,FID 2.48 对原版 2.27。
Sleep 赢过 SEAL 和测试时训练吗?
论文报告的每个基准都赢了:ARC 小样本 80% 对 SEAL 72.5%、TTT 10%;单段 SQuAD 48.9% 对 46.7%。保留意见是:最大的长上下文提升来自睡眠日程底下定制的 Hope 记忆架构,数学上对 OPSD 的优势是 AIME-24 +2.6%,窄但一致。
两条路线能结合吗?
两篇论文都没有排除,而且设计几乎正交:TTT 层的逐 token 适配便宜且不持久,正是 Sleep 框架对”醒着”阶段的预期。装了 TTT 层的模型在睡眠时能否把推理期适配巩固下来,是两篇论文都没回答的开放问题。