
高效 AI · 语言模型 · Transformer
推测解码原理详解:草稿、验证与接受率上限
小模型先猜几个 token,大模型一次前向验证,拒绝采样保证输出分布不变。整场游戏就是有多少草稿 token 能活下来,2026 年的收益来自训练和重构草稿模型,而不是目标模型。
工作原理
自回归解码每生成一个 token 就要跑一次目标模型的完整前向,小批量下这次前向的时间花在读取权重上而不是算术上。推测解码填的就是这段空闲算力。一个便宜的草稿模型先提出 k 个候选 token,目标模型在一次前向里给全部 k 个位置打分,和给提示打分完全一样,然后接受它认可的最长前缀。
“认可”的定义保证输出分布不变。贪心验证下,草稿 token 只有等于目标模型的 argmax 才被接受。标准的无损规则是拒绝采样:从草稿分布 q 采出的 token v,在目标分布 p 下以概率 min(1, p(v)/q(v)) 被接受,被拒时从残差分布里采一个修正 token。每个位置的期望接受概率等于 1 减去 p 与 q 的总变差距离。可以证明被接受的 token 的分布与目标模型独自生成时完全相同;唯一改变的是耗时。
代价模型随之而来。如果草稿模型几乎免费,目标模型平均每次验证接受 tau 个 token,加速比就趋近 tau。本文里的每个方法都是在抬高 tau、降低草稿成本,或者防止 tau 衰减。
关键数字
| 测量项 | 数值 | 设置与出处 | 同一套评测? |
|---|---|---|---|
| Qwen3-4B 思考模式,加速比 / 接受长度 | Draft-OPD 4.86 倍,tau 5.96;DFlash 4.33 倍,5.51;EAGLE-3 3.87 倍,5.33 | 温度 0,Draft-OPD 论文 | 是 |
| Qwen3-8B 思考模式 | Draft-OPD 4.89 倍,tau 5.73;DFlash 4.34 倍,5.19;EAGLE-3 4.06 倍,5.64 | 同上 | 是 |
| 在线策略草稿训练的总收益 | 比 EAGLE-3 高 23%,比 DFlash 高 13% | 算力匹配,Draft-OPD | 是 |
| 解耦并行草稿的端到端加速 | Transformers 后端最高 5.49 倍;SGLang 下吞吐最高 5.8 倍 | Domino 论文 | 自有基线 |
| RL 中 TV 损失训练的 MTP 头接受率 | 约 95%,比交叉熵训练高约 10 个百分点 | Qwen3.5-35A3B,gamma = 3,Bebop | 是 |
| RL 中接受率对策略熵的斜率 | -1.68(贪心,或拒绝采样加 CE)→ -0.06(拒绝采样加 TV 损失) | Bebop 图 8 | 是 |
| 各领域接受率,CE → 端到端 TV | SWE-Bench 75.1 → 83.1;智能体 90.3 → 97.0;数学 75.0 → 78.0;MT-Bench 65.3 → 67.6 | Bebop | 是 |
| 带 MTP 的 RL 采样延迟 | 每步低 1.5 到 1.8 倍;智能体采样 2.4 倍;异步 RL 端到端最高 1.8 倍 | Qwen3.5 / 3.6 / 3.7,Bebop | 是 |
| 扩散语言模型内部的推测解码 | 平均精度 +5.04 分,3.86 倍提速 | FeF-DLLM,GSM8K / MATH / HumanEval / MBPP | 扩散语言模型内部 |
| 输出分布 | 由拒绝采样的构造保证不变 | 所有方法 | 不适用 |
加速比对批大小、硬件和基座模型都很敏合;两行 Qwen3 数字是最干净的同条件对比,因为三个草稿模型跑在相同的目标模型上。
上限从哪来
接受长度受限于草稿模型对目标模型的贴合程度,有三样东西在侵蚀它。
离线训练。 EAGLE-3 和 DFlash 这类草稿模型用目标模型的文本做监督微调,从未见过自己起草时会到达的状态。Draft-OPD 指出症状是接受长度在 SFT 中进入平台期,修法是目标辅助的采样加上从草稿被拒位置的回放,对被接受的 token 用前向 KL、对被拒的 token 用反向 KL。比 EAGLE-3 高出的 23% 就来自这里。
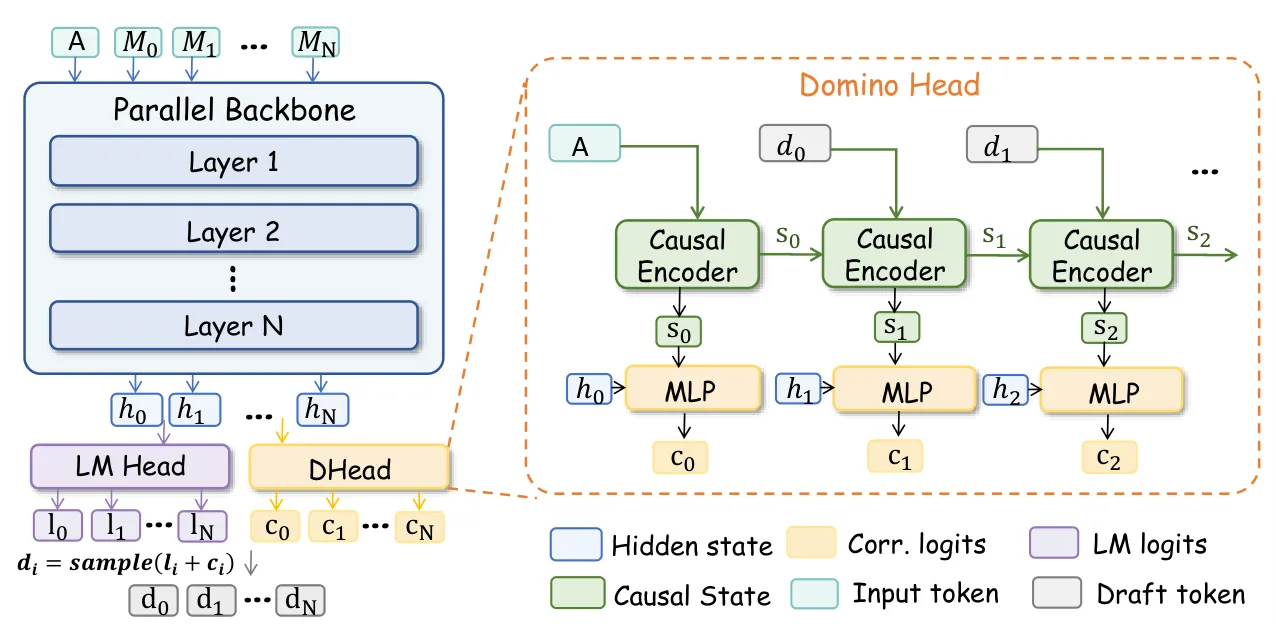
并行起草。 一次并行猜出全部 k 个 token 很快,但每个位置看不到相邻位置,整块内部不一致,目标模型会拒绝更多。自回归草稿模型修好了一致性,代价是 k 次顺序前向。Domino 把两项工作拆开:并行骨干提出整块,一个小的因果头用已确认前缀改写它,基座锚定的课程防止骨干在头学习期间退化。报告的 5.49 倍和 5.8 倍来自每步接受 token 数更高,而不是草稿更便宜。
熵。 强化学习期间策略的熵会有意上升,Bebop 证明贪心验证下的接受率被这个熵线性地限制住:alpha 约等于 a 减 b 乘 H(p)。换成拒绝采样让衰减变平滑,但打不破这个界;用 KL 或交叉熵训练草稿头也打不破。用总变差损失训练它,也就是拒绝采样真正依赖的那个量,斜率从 -1.68 压平到 -0.06,整个 RL 过程接受率保持在 95% 附近。
对扩散解码器意味着什么
同样的”先验证再接受”思路在自回归之外也成立。扩散语言模型每步去掩很多 token,但彼此独立预测,引入了因子分解误差。FeF-DLLM 让干净 token 的后验精确地以前缀为条件,这本来是顺序的,再用每个去噪步内部的推测解码找回并行性:平均精度多 5.04 分,相对顺序的精确版本提速 3.86 倍。
局限与存疑
上面每个加速比都是对作者自己的基线、在一个模型家族上测的,主要是 Qwen3;跨家族迁移是假设。Draft-OPD 在 4096 token 序列上训练、在 8192 上评测。Domino 的摘要没有在固定设置下和 EAGLE 或 Medusa 正面比较接受长度。Bebop 的 TV 损失需要融合的全词表 kernel,top-20000 近似会拖慢收敛;收益在分布内(SWE-Bench 接受率 +8.0,MT-Bench +2.3)。而且没有一篇论文在相同的 RL 熵条件下对比非 MTP 草稿模型,所以”TV 是 MTP 头的最佳损失”成立,“MTP 是最佳草稿模型”不成立。
常见问题
推测解码这种方法是无损的吗?
验证使用拒绝采样时是:草稿 token 以概率 min(1, p/q) 被接受,被拒时采一个修正 token,被接受的输出分布与目标模型独自生成完全相同。贪心验证相对目标模型的贪心解码也是无损的。变的只有速度。
2026 年推测解码在基准上能带来多大加速?
在温度 0 的 Qwen3 思考模型上,Draft-OPD 在 4B 上达到 4.86 倍、8B 上 4.89 倍,接受长度接近 6,EAGLE-3 是 3.87 倍和 4.06 倍。Domino 报告 Transformers 后端最高 5.49 倍、SGLang 下吞吐 5.8 倍。数字随批大小和硬件变化。
RL 训练期间推测解码的接受率为什么下降,如何修复?
因为 RL 为了探索而抬高策略熵,而贪心或 CE 训练的草稿在熵上升时接受率线性下降,Bebop 测得斜率约 -1.68。在拒绝采样下用总变差损失训练草稿头,斜率压平到 -0.06,接受率保持在 95% 附近。
推测解码里 EAGLE 式和 Medusa 式草稿模型有什么区别?
EAGLE 式草稿模型是自回归的,每个草稿 token 都看到前面的 token,接受率高,代价是每个 token 一次顺序前向。Medusa 式的头并行起草整块,便宜但不一致。Domino 把两者结合:并行骨干提出,小的因果头修补整块。