
KV 缓存压缩原理详解:量化、卸载、压缩还是替换
长上下文里耗尽显存的是 KV 缓存而非权重。2026 年四条路线:撑过长解码的 2 比特量化、13.5% 常驻的前瞻卸载、1:16 软 token 压缩、固定大小记忆。
工作原理
Transformer 处理的每个 token 都在每一层留下一个 key 向量和一个 value 向量。解码下一个 token 要读取全部这些向量,所以缓存随上下文线性增长,而且每一步都被重读。到 50 万 token 时,放不下 GPU 的是缓存而不是模型;而只要上下文超过几千 token,解码就受显存带宽限制,这意味着缓存的字节数就是延迟。
有四个位置可以下手,本文的论文各占一个。
每个条目存更少比特。 KVarN 把 key 和 value 量化到 2 比特,不需要校准集。它的诊断是:此前的方法都在类似预填充的设置下测量,只有一次误差,而推理模型要解码数千 token,每一步都重读每个量化条目,误差会累积。主因是少数 token 的尺度是离群值。先用 Hadamard 旋转把离群值分散到各通道,再沿 K 和 V 的两个轴做双重缩放的方差归一化,在舍入之前修正逐 token 的尺度。
常驻更少条目。 FlashMemory-DeepSeek-V4 保持缓存完整,但预测下一段解码会关注哪些块。一个双编码器神经记忆索引器把各块对即将到来的查询状态打分,只把最高的几块留在 GPU 上,其余卸载出去。索引器本质是检索器,可以用现成的检索工具链训练,不必加载前沿骨干模型。
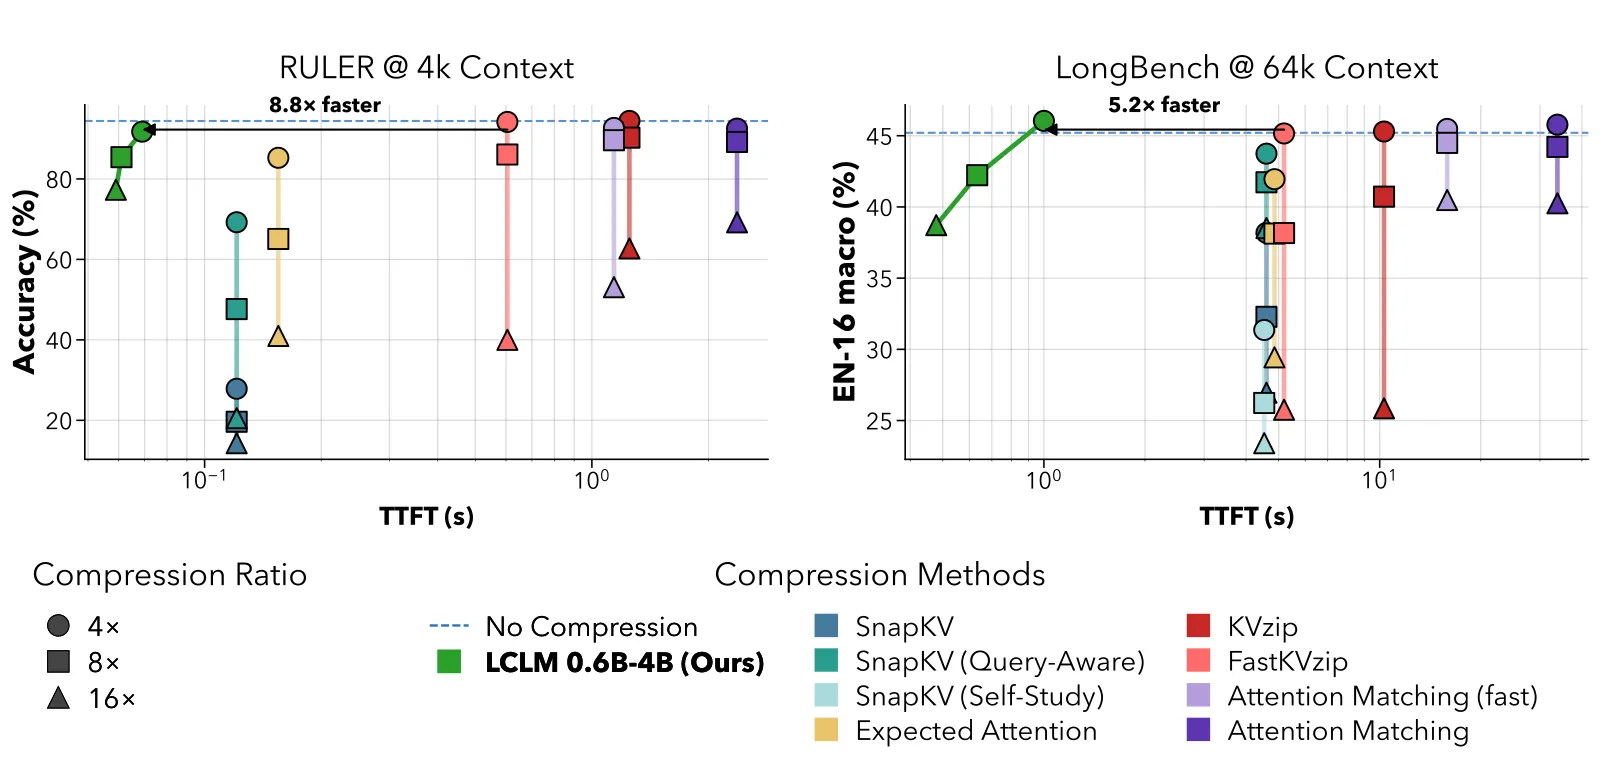
在解码器看到 token 之前压缩。 End-to-End Context Compression at Scale 联合训练一个 0.6B 编码器和一个 4B 解码器,让每 4、8 或 16 个 token 的块变成一个软 token。解码器的预填充和缓存按这个比例缩小。编码器学的是解码器需要什么,一个重建辅助损失防止软 token 塌缩。
改变缓存的内容。 两篇论文把逐头的 key 和 value 换成更小的东西。VideoMLA 把多头潜在注意力带进因果视频扩散:一个共享的低秩内容潜变量加一个解耦的位置 key,实时重建成逐头的 K 和 V。delta-mem 更进一步,窗口固定不动,用一个 8×8 的联想记忆按 delta 规则更新来携带历史,再以低秩修正的形式读回冻结模型的注意力里。
关键数字
| 路线 | 测量项 | 数值 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 量化 | 能保住精度的精度位数 | 2 比特,无需校准 | KVarN,MATH500 / AIME24 / HumanEval | 是,对此前 2 比特方法 |
| 量化 | 针对的失效模式 | 误差随解码步累积,由离群 token 尺度驱动 | KVarN 分析 | 不适用 |
| 卸载 | 解码时常驻 GPU 的 KV 缓存 | 平均为全上下文基线的 13.5% | FlashMemory,LongBench-v2 / LongMemEval / RULER | 是 |
| 卸载 | 500K 上下文 | 削减超过 90% 的缓存开销 | FlashMemory | 是 |
| 卸载 | 精度变化 | 平均 +0.6 分 | FlashMemory | 是 |
| 压缩 | 压缩比 | 1:4、1:8、1:16 软 token | LCLM,0.6B 编码器 + 4B 解码器,350B 训练 token | 是 |
| 压缩 | 峰值显存随上下文的变化 | 趋于平台;KV 基线在 512K 到 1M 附近耗尽 | LCLM 对 SnapKV、KVzip、Attention Matching | 是 |
| 压缩 | 精度 | 1:4 接近未压缩的 4B 解码器;1:16 有可测损失 | LCLM,RULER / LongBench | 是 |
| 压缩 | 精确检索的找回 | EXPAND(i) 工具返回原始 512 token 块,接近未压缩基线 | LCLM 大海捞针测试 | 是 |
| 替换 | 每 token KV 显存 | 224 个标量对 3072,削减 13.7 倍(92.7%) | VideoMLA,每个缓存层 | 是 |
| 替换 | 质量与吞吐 | 60 秒处 VBench 0.859,评测方法中最佳;单张 B200 吞吐 1.23 倍;批大小最多 8 倍 | VideoMLA | 是 |
| 替换 | 固定大小记忆 | 8×8 状态;相对冻结骨干 1.10 倍,相对最强记忆方法 1.15 倍,MemoryAgentBench 1.31 倍 | delta-mem | 是 |
各行都是方法与自己基线的比较。没有一篇论文在同一模型上把量化、卸载和上游压缩正面比过,所以这张表告诉你每条路线能做到什么,不告诉你哪条赢。
每条路线的取舍
量化最容易采用,上限也最明确:2 比特对 16 比特是缓存显存 8 倍的削减,再多也没有,而 2 比特下剩余的精度差距是被接受的,不是被消除的。KVarN 的贡献是让 2 比特撑过长解码,它没有改变上限。
卸载保留完整的注意力语义,常驻缓存约减 7 倍,但要多服务一个模型,预测也可能失手。FlashMemory 平均 +0.6 的背后,藏着索引器丢掉恰好装着答案那一块的情形,总体精度显示不出来。
上游压缩是唯一显存曲线随上下文趋平的路线,所以它能在缓存淘汰基线耗尽的同一硬件上到达 1M token。代价是精确回忆:1:16 有可测的精度损失,论文给的补救,一个按需展开原始块的智能体工具,又把成本推回原始 token。
替换缓存最具侵入性,合适时回报也最大。VideoMLA 的 13.7 倍在预训练视频注意力并不低秩的情况下仍然成立,因为潜在瓶颈决定了模型训练进去的有效秩。delta-mem 的 8×8 状态根本不是压缩的缓存,它是另一种记忆,几百轮对话下的上限还没有人测过。
怎么选
- 32K 到 128K 上解码长思维链的推理模型: KVarN 式、在真实解码下测过的 2 比特量化;确认 kernel 预算装得下 Hadamard 那一步。
- 超过 256K 的单个长文档或智能体历史,需要精确答案: 前瞻卸载。盯住平均值掩盖的针式失效。
- 服务大量长上下文、约束是显存而不是每个 token 的精度: 1:4 到 1:8 的上游软 token 压缩,给检索密集的请求配一个展开工具。
- 固定窗口的视频或其他流式生成: VideoMLA 式的潜在 KV,批大小的余量就是回报。
- 对话记忆而非文档上下文: delta-mem 这类固定大小循环记忆,前提是它相对其他记忆方法的 1.15 倍在你的基准上成立。
局限与存疑
各路线的评测面不同:KVarN 报告数学和代码;FlashMemory 报告对检索友好的套件;LCLM 用的是 0.6B 和 4B 模型;VideoMLA 是一个模型在一张 B200 上;delta-mem 报告的是相对倍数,绝对基线要去论文里读。没有一篇在共享服务器上带全部开销测过端到端每秒 token 数,路线之间的组合,比如量化一个卸载后的缓存、或压缩一个潜在缓存,也没有探索。模型侧的设计还在移动球门:DeepSeek-V4 的压缩与重度压缩注意力层报告 1M token 下 KV 缓存只有 V3.2 的 10%,这是对同一个问题的另一种回答。
常见问题
KV 缓存压缩是什么方法,长上下文为什么需要它?
KV 缓存为每层每个 token 存一个 key 和一个 value 向量,每个解码步都要重读,因此随上下文线性增长,过了几十万 token 就主导 GPU 显存。压缩通过量化条目、卸载非常驻块、在解码器看到之前压缩 token,或用更小的潜变量替换逐头 key 和 value 来缩小它。
2 比特 KV 缓存量化在基准上会损害精度吗?
比过去小得多。KVarN 表明真正的损害来自离群 token 尺度导致的长解码误差累积,它的 Hadamard 旋转加双轴方差归一化在真实解码下测量,在 MATH500、AIME24 和 HumanEval 上刷新了 2 比特的最好结果,且不需要校准数据。
KV 缓存卸载和压缩对比能省多少显存?
FlashMemory 平均只让 13.5% 的缓存常驻,500K 上下文下削减超过 90%,精度 +0.6,并且保留完整注意力。潜在上下文压缩在 1:16 下把解码器的预填充和缓存按该比例缩小,是唯一峰值显存在趋向 1M token 时趋平的路线,代价是可测的精度损失,可用展开工具找回。
推理模型该用哪种 KV 缓存压缩方法?
32K 到 128K 的思维链,先用 KVarN 这类在解码下验证过的 2 比特量化。超过 256K 再加前瞻卸载。当大量并发长上下文必须装进显存、又不要求每个 token 都精确回忆时,用上游软 token 压缩。