
Kimi K3 架构解读:KDA、注意力残差与 LatentMoE
Kimi K3 三层 delta 规则线性注意力配一层全局 MLA,深度上对前置层做注意力,经半宽潜变量路由到 896 选 16 的专家;缩放效率约为 K2 的 2.5 倍。
架构一览
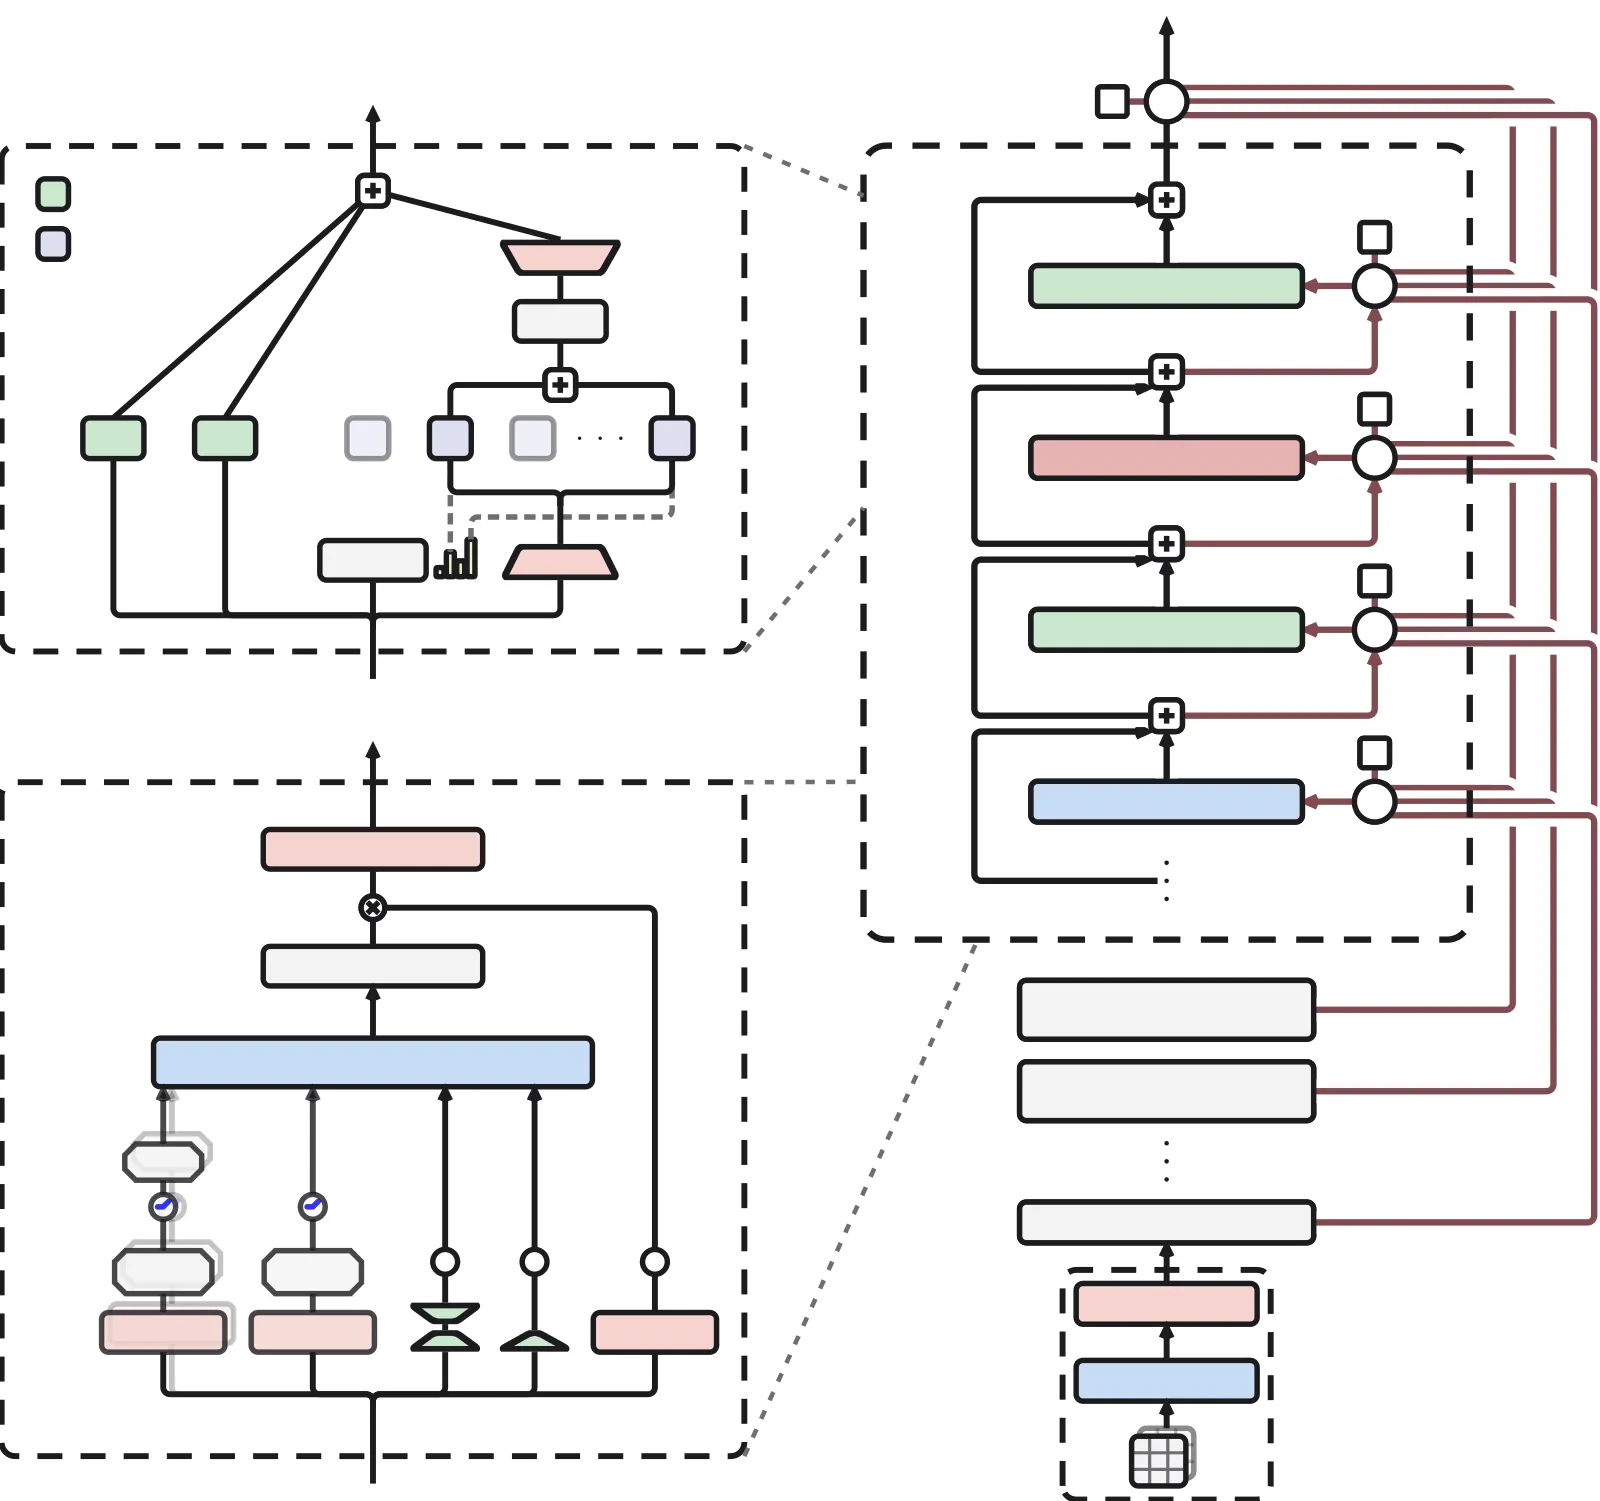
Kimi K3 报告 围绕三条混合轴组织模型:跨 token、跨层、跨通道。沿 token,每个块叠三层 Kimi Delta Attention(KDA)和一层门控多头潜在注意力,末尾再加一层门控 MLA,保证最后一层始终是全局注意力。沿层,注意力残差用对前置层输出的注意力取代单一的累积残差。沿通道,Stable LatentMoE 经 3584 维潜变量(7168 隐层宽度的一半)把每个 token 路由到 896 个专家中的 16 个外加 2 个共享专家。从零训练的视觉塔 MoonViT-V2 接入同一骨干。矩阵用 Muon 训练,注意力投影按头正交化。总量:93 层,2.78T 参数,104.2B 激活,1M token 训练上下文。
关键数字
| 维度 | Kimi K2 | Kimi K3 | 出处 | 同一套评测? |
|---|---|---|---|---|
| 总参数 / 激活参数 | 1.04T / 32.6B | 2.78T / 104.2B | K3 报告表 1 | 不适用 |
| 层数 / 注意力头数 | 61 / 64 | 93 / 96 | 表 1 | 不适用 |
| 注意力 | 每层 MLA | 3 KDA : 1 门控 MLA,末尾再加一层门控 MLA | 表 1,2.1 节 | 不适用 |
| 路由专家 / 每 token 激活 / 共享 | 384 / 8 / 1 | 896 / 16 / 2 | 表 1 | 不适用 |
| Latent MoE 维度 | 无 | 3584(隐层的 0.5 倍) | 表 1 | 不适用 |
| 每专家 MoE 隐层 | 2048 | 3072 | 表 1 | 不适用 |
| 训练上下文 | 128K | 1M | 表 1 | 不适用 |
| 深度混合 | 标准残差 | 块级注意力残差,8 块各 12 层 | 2.2 节 | 不适用 |
| 优化器 | Muon | 注意力投影上的逐头 Muon | 2.5 节 | 不适用 |
| 缩放效率 | 1 倍 | 约 2.5 倍(拟合缩放律) | 图 7 | 是,同一实验室的拟合 |
| 发布时 WebDev Arena / AA 智能指数排名 | 不适用 | 99 个中第 1(Elo 1678)/ 580 个中第 4(57.1) | 第三方,2026 年 7 月 23 日 | 不适用 |
2.5 倍是同一实验室两代模型之间的拟合曲线比较,包含数据和配方的变化;报告没有分别消融 KDA、AttnRes 和 MoE 的改动。
token 混合:KDA 是什么,为什么是 3:1
KDA 是一种线性注意力层,维护固定大小的循环状态,用 delta 规则更新它,即覆盖状态对某个 key 当前的预测而不是在上面累加,并按通道加门,让不同维度以不同速率遗忘。它和 Mamba 的选择性状态空间、Gated DeltaNet 同出一族,继承了它们的性质:每 token 解码代价恒定,没有增长的 KV 缓存。K3 相对 Kimi Linear 改了两处。对数衰减用缩放 sigmoid 设下界,取代无界的负 softplus,使分块计算的每个因果 tile 都能跑稠密的 Tensor Core 矩阵乘,而不是逐位置的显式循环。输出门在逐头 RMSNorm 之后变成依赖输入的满秩投影。
3:1 的比例存在,是因为固定大小的状态做不了精确检索。带压缩 KV 的全局注意力层让每个 token 都可寻址,中间三层便宜的层把长程代价压下来。最后一层全局层保证输出头之前的最后一步计算能看到一切。Qwen3.8-Next 用 Gated DeltaNet 达到同样的 3:1 分配,并发布了背后的受控消融:25B-A3B 上 GDN 混合平均 53.81,全注意力 49.87,滑动窗口混合 51.15。K3 没有发布这个消融,所以 Qwen 的数字是这个比例正确的最好可得证据。
深度混合:注意力残差
残差流把第 L 层之前的一切压成一个向量,报告把它比作沿深度的 RNN。注意力残差让第 L 层以数据相关的权重关注所有前置层的输出,就像自注意力取代了沿位置的递推。对 93 层做完整 AttnRes 代价高,所以 K3 把层分成 8 块各 12 层,在块级表示加嵌入层上做注意力;报告称这找回了大部分收益,并描述了控制推理成本的 online-softmax 实现。这和 DeepSeek V4 的流形约束超连接、Qwen3.8-Next 的四分支门控残差是不同的答案:三者都在加宽或重接残差路径,但只有 K3 把它做成了注意力。
通道混合:Stable LatentMoE
同时扩大专家池和激活专家数能拓宽专业化空间,但常规 MoE 里每个选中的专家都接收完整隐层宽度,通信随路由数目增长。LatentMoE 把模型宽度和路由专家宽度分开:共享专家保留全宽路径,路由专家在 3584 维潜变量上运算。K3 为这种稀疏度加了三个稳定器。专家聚合与上投影之间的 RMSNorm 防止路由分支的尺度随激活的专家而变化。SiTU-GLU,一种 sigmoid-tanh 门控线性单元,给激活的两个分支限界。Quantile Balancing 用一条从分配问题松弛推导、用直方图估计的路由规则取代辅助损失均衡,在 896 选 16 下保持负载均匀。
优化器:逐头 Muon
K3 像 K2 一样用 Muon 训练矩阵,但对 Q、K、V 投影是沿头维度切分动量、分别正交化每个头的块。理由是整矩阵正交化把范数和角色各不相同的头耦合在一起;Pion 论文为 RL 微调独立地得出了同样的逐头设计。DeepSeek V4 用整矩阵 Muon 加 logit 爆炸防护,Qwen3.8-Next 则在发现 Muon 让 MoE 路由器不稳后把路由器留给 AdamW。
局限与存疑
架构作为一个整体连同拟合的 2.5 倍效率增益一起呈现;没有发布逐组件消融,各部分贡献的大小未知。KDA 的 3:1 比例借用了 Qwen 在更小规模上的 GDN 消融作为证据。块级 AttnRes 被描述为找回了完整 AttnRes 的大部分收益,但没有数字。1M 上下文和智能体结果虽强,却是在月之暗面的评测框架下以最大推理强度运行的,刻画的是模型加后训练,而不是架构本身。
常见问题
一段话说清 Kimi K3 的架构是什么?
93 层、2.78T 参数、104.2B 激活的 MoE。每个块有三层 Kimi Delta Attention 和一层门控 MLA;注意力残差让各层以 12 层为块读取所有前置层;Stable LatentMoE 经 3584 维潜变量把 token 路由到 896 个专家中的 16 个;矩阵用逐头 Muon 训练;原生的 MoonViT-V2 塔提供视觉。
Kimi K3 的注意力和 DeepSeek V4 的有什么不同?
K3 每四层中三层用线性 delta 规则注意力(KDA)、第四层用压缩的全局 MLA,所以大多数层没有增长的 KV 缓存。DeepSeek V4 每层都保留注意力,但把成组 token 压成单个 KV 条目并稀疏地关注 top-k,1M token 下把缓存缩到 V3.2 的 10%。两者都加滑动窗口补局部细节。
Kimi K3 里的注意力残差是什么?
一种深度混合机制,每一层以数据相关的权重关注前置层的输出,而不是读取单一的累积残差向量。K3 为控制成本,用 8 块各 12 层的块级变体。
Kimi K3 为什么用 896 个专家却只激活 16 个?
因为 LatentMoE 经半宽潜变量路由 token,扩大专家池不会让通信随激活专家数增长,而 Normalized LatentMoE、SiTU-GLU 和 Quantile Balancing 让训练在这种稀疏度下保持稳定。