
Chinchilla 和 GPT-3 的区别:一篇终结「只堆参数」时代的论文
GPT-3 把 175B 参数押在约 300B token 上;Chinchilla 重做 scaling 实验,证明数据应与参数等比例增长,70B 模型配 1.4T token 反超。
相隔两年的两个相反赌注
两篇论文出自同一个 scaling law 传统,但对「训练预算怎么花」给出了相反答案。GPT-3(2020)是纯参数赌注:架构沿用 GPT-2,把规模推到 1750 亿参数,比此前所有非稀疏语言模型大 10 倍,训练数据约 3000 亿 token,赌的是能力会随规模自己涌现。支撑这个赌法的是 2020 年 Kaplan 等人的 scaling law:算力增长应该主要灌进参数,数据只小幅增加。
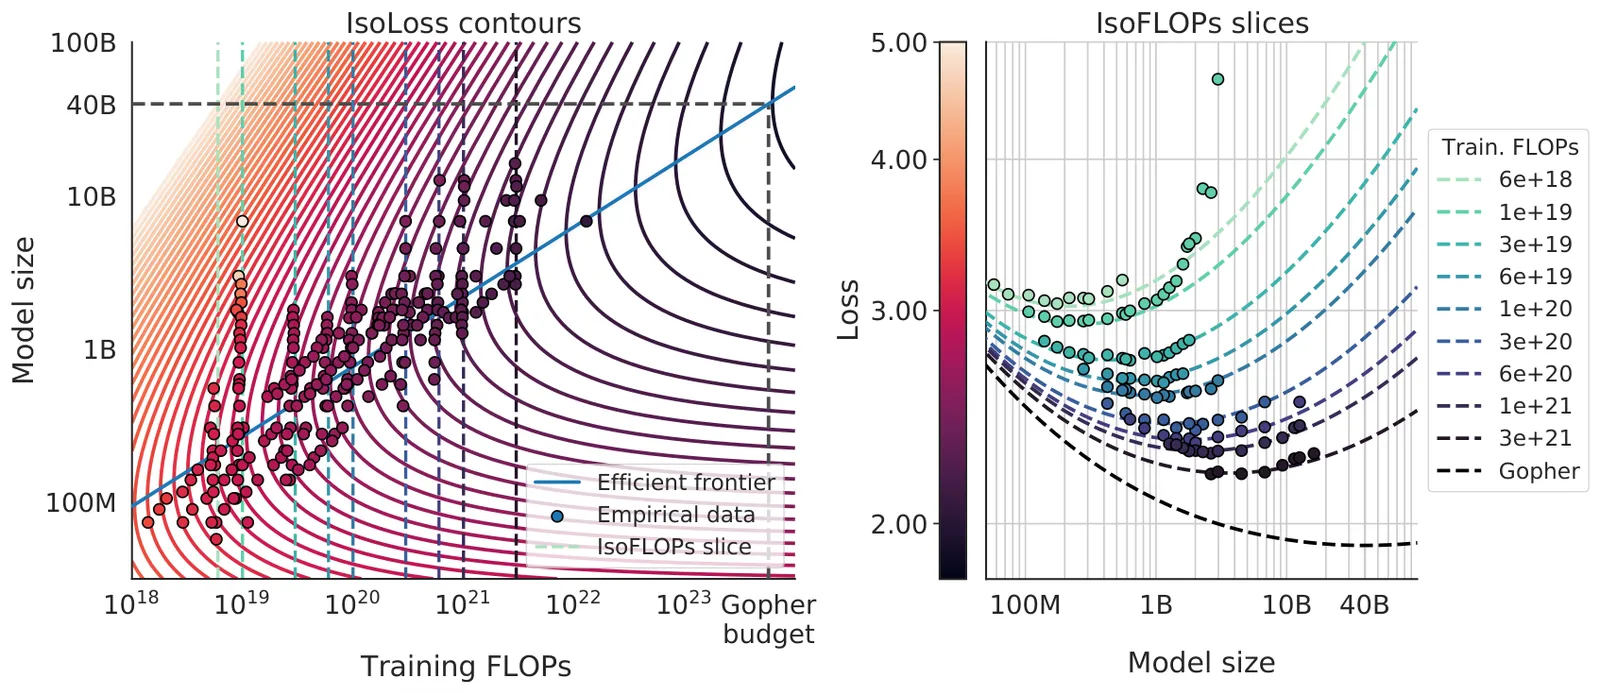
Chinchilla(2022)是这个结论的修正者。DeepMind 用没人做过的细粒度重做了实验:400 多个模型,参数量从 7000 万到 160 多亿,训练数据从 50 亿到 5000 亿 token,用三种独立方法拟合损失曲面。三种方法互相吻合,却和 2020 年的建议相矛盾:参数和 token 的指数大致相等,应该等比例增长。照这个算法,一个 530B 的模型要算力最优,需要约 10 万亿 token,而当时没人给这些巨模型喂过这么多。
关键数字
| 测量项 | GPT-3 | Chinchilla | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| 参数量 | 175B | 70B | 两篇论文各自给出 | 不适用 |
| 训练 token 数 | 约 3000 亿(按 Chinchilla 的口径) | 约 1.4 万亿,约为 Gopher 的 4 倍 | Chinchilla 论文 | 语料不同 |
| 每个参数的 token 数 | 约 1.7 | 约 20 | 由上两行直接算出 | 不适用 |
| 算力关系 | 不适用 | 与 280B 的 Gopher 用相同 FLOPs | Chinchilla 论文 | 仅限 DeepMind 内部可比 |
| MMLU 平均分 | 站上页面未给出 | 67.5%,比 Gopher 高 7 分以上 | Chinchilla 论文 | 站内没有 GPT-3 的 MMLU 数字 |
| 下游任务套件 | 在该套件下 uniformly 低于 Chinchilla | 在该套件下 uniformly 高于 Gopher 280B、GPT-3 175B、Jurassic-1 178B、MT-NLG 530B | Chinchilla 论文自评套件 | 是,五个模型同一套 |
| 与 GPT-3 的体积差 | 基准 | 参数量为 GPT-3 的约 40%(对 MT-NLG 530B 则约为 13%) | Chinchilla 论文 | 不适用 |
| scaling 研究覆盖范围 | 对比曲线最小到 1.3B | 400 个模型,70M 到 16B+,5B 到 500B token | 两篇论文各自给出 | 不适用 |
| 核心能力标签 | few-shot 上下文学习:LAMBADA 约 86%、TriviaQA 约 71%,权重零更新 | 训练经济学:修正预算分配,架构零改动 | 各自论文 | 回答的是不同问题 |
看这张表,先看它缺什么。站内页面没有 GPT-3 的 MMLU 数字(GPT-3 早于这个评测习惯);「uniformly 更高」那一行出自 Chinchilla 论文自己的下游套件,不是把 GPT-3 放到中立条件下重跑。两篇论文回答的其实是不同问题,所以最后一行最关键:GPT-3 讲的是一个巨大的冻结模型在推理时能买到什么,Chinchilla 讲的是固定训练预算该怎么分。两者互补,不是互相替代。
GPT-3 的规模到底买到了什么
GPT-3 论文的主张从来不是一个榜单数字,而是:规模能把提示词变成任务接口。把任务说明和几个示例放进上下文,权重一动不动,模型就能干活。论文在每个任务上都测了 zero-shot、one-shot、few-shot(通常 10 到 100 个示例),真正的发现是交互效应:小模型几乎吃不到上下文示例的红利,GPT-3 受益巨大。175B 买到的质变是这个。
GPT-3 页面上的具体 few-shot 数字:LAMBADA 完形填空约 86%,明显高于此前的 zero-shot 最好成绩;开放域 TriviaQA 约 71%,和有大量监督训练的精调系统打平;还有打乱字母还原、用新定义的词造句、三位数算术这类即兴任务,之前的语言模型完全无法只靠提示完成。人类评审几乎分不清 GPT-3 写的短新闻和人写的。真正留下来的遗产是接口转变:任务适配从优化器里搬进了上下文窗口,后来所有提示工程和指令调优的工作都在这个模板上展开。
PaLM:参数优先赌注的极致形态
和 Chinchilla 同年,答案相反。PaLM是一个 5400 亿参数的全激活 decoder-only Transformer,Google 用 Pathways 系统跨两个 TPU v4 Pod、共 6144 块芯片训出来,刻意不走混合专家路线,论证的是把系统工程做足,稠密的参数 scaling 就还能继续。PaLM 页面没有给出它的训练 token 数,所以诚实的对比只能停在架构层面:PaLM 把参数优先配方推到极致的那一年,恰恰是 Chinchilla 证明这个配方预算分配错误的那一年。
按 PaLM 页面的记录,这个赌注依然买到了真能力:配上思维链提示,PaLM 540B 只靠 few-shot 提示就在一组多步推理任务上追平或超过精调的最好成绩,在 BIG-bench 综合指标上超过了人类平均分。它的 BIG-bench 曲线在最大规模处出现不连续的跳升,这是「涌现」说法最尖锐的证据,但论文自己只记录了这个现象,没有解释。同一页面对代价也很坦白:稠密 540B 模型训练和部署都昂贵,模型越大记住的训练数据越多,带来隐私和版权问题,「超过人类平均」是许多任务上的平均,不等于赢下了难题。PaLM 是 GPT-3 哲学最有力的正方,Chinchilla 是对其预算分配最有力的反方;两个都拿着,才看得懂那几年。
Chinchilla 修正了什么
Chinchilla 的论点是:GPT-3 那一代模型不是太小,是严重没喂饱。Gopher、GPT-3、MT-NLG 不管参数量是 175B 还是 530B,训练数据都停在约 3000 亿 token。Chinchilla 用自身证明重新分配胜过堆体积:70B 参数、约 1.4 万亿 token,和 280B 的 Gopher 用一模一样的算力。没有架构技巧,没有新目标函数,只是把预算分配改对了。
Chinchilla 论文的结果:MMLU 平均 67.5%,当时是最好成绩,比 Gopher 高 7 分以上;在一个大下游套件上全面超过 Gopher(280B)、GPT-3(175B)、Jurassic-1(178B)和 Megatron-Turing NLG(530B),而体积只有那些模型的几分之一(是 GPT-3 的约 40%)。而且因为模型更小,微调和部署成本都显著更低,效率红利在上线之后继续复利,不止省在训练那一次。
怎么读这场正面对决
在把上表当结论之前,有三点要留意。第一,下游套件那一行是 Chinchilla 论文自己的评测;GPT-3 页面既没报那个套件也没报 MMLU,所以「全面超过 GPT-3」是一家实验室的测量,不是中立重赛。第二,token 数来自不同语料——GPT-3 用 Common Crawl 加少量高质量来源,Chinchilla 用 DeepMind 的数据,所以预算分配的对比比数据质量的对比干净。第三,两者的贡献是互补的:GPT-3 证明了巨大冻结模型在推理时能做什么,Chinchilla 证明了固定训练预算该怎么分。一个现代系统要同时吃下两课:一个喂得饱的模型,加一个装得下任务的提示词。
怎么选
- 在训新基座、训练算力是瓶颈: 从 Chinchilla 经验法则起步:参数翻倍,数据翻倍;每个参数约 20 个 token 作为算力最优的锚点。GPT-3 那种每个参数约 1.7 个 token 的分配,如今是被文献记录下来的错误,不是风格选择。
- 模型要服务几十亿次、推理成本占大头: Chinchilla 页面自己就带着反方观点。算力最优最小化的是单次训练的成本;如果一个检查点被运行的次数远多于它被训练的次数,就该刻意超喂一个更小的模型、喂过它的算力最优点,也就是 LLaMA 的论证,来摊薄每次查询的成本。
- 高质量文本是稀缺资源: 「数据翻倍就好」的建议会在 token 预算撞上数据质量天花板时失效,这正是这几年整个行业一直在顶着的约束。
- 在设计用户和模型的交互方式: GPT-3 的这一课不受任何 scaling law 修正的影响。zero/one/few-shot 提示,连同它对措辞和示例顺序的敏感,是这篇论文确立的接口行为,和训练时喂了多少 token 完全正交。
局限与存疑
Scaling law 是经验曲线拟合,不是物理定律:指数会随数据质量、分词器、架构和优化器日程移动,Chinchilla 的原始系数后来就被复现工作重新推导、质疑,并在一份勘误里部分修正过。两篇论文也都是预训练经济学成果,对指令调优、对齐、工具使用无话可说。GPT-3 页面自己就指出,后来的大量工作存在的意义恰恰是补它暴露的窟窿。而这个对比最想要的干净受控实验,两篇都没做:在相同数据和评测下,把 GPT-3 按每个参数 20 个 token 重训一遍,好把预算分配和 2020 年 OpenAI 与 2022 年 DeepMind 之间的一切其他差异分开。
常见问题
Chinchilla 比 GPT-3 大吗?
不。Chinchilla 是 700 亿参数,对 GPT-3 的 1750 亿,大约只有六成不到的参数(约为 40%)。差别在数据:Chinchilla 看了约 1.4 万亿 token,约为 GPT-3 那约 3000 亿的 4 到 5 倍,这正是它能在 Chinchilla 论文的下游套件上以小胜大的原因。
Chinchilla 真的打赢 GPT-3 了吗?
在 Chinchilla 论文自己的下游评测里,是:它全面超过 GPT-3 175B、Gopher 280B、Jurassic-1 178B、MT-NLG 530B,MMLU 拿到 67.5%。站内页面没有 GPT-3 的 MMLU 数字,而且评测套件出自 Chinchilla 一方,所以请把它读作一家实验室的受控对比,而不是中立重赛。
GPT-3 到底训练了多少 token?
按 Chinchilla 页面采用的口径,约 3000 亿,平均每个参数约 1.7 个 token,这正是 Chinchilla 论文攻击的「没喂饱」。GPT-3 自己的页面只描述了语料构成(Common Crawl 加更高质量来源),没有给出精确 token 数。
Chinchilla 经验法则是什么?
算力最优训练下,模型规模和训练 token 等比例增长:参数量每翻倍,数据也翻倍。落到实操上大约是每参数 20 个 token,就是 Chinchilla 自己 1.4T token 对 70B 参数的比值。
我还该按 GPT-3 的方式训吗:超大模型配有限数据?
只有一种情况合理:模型要被服务极多次,推理成本压过训练成本,这时你刻意超喂一个更小的模型、喂过它的算力最优点,让每次查询更便宜。对单次训练、预算固定的场景,Chinchilla 分配才是修正后的默认答案。