
LLM RL 训练失稳对比:DRPO 平滑信任域与跨域干扰修复
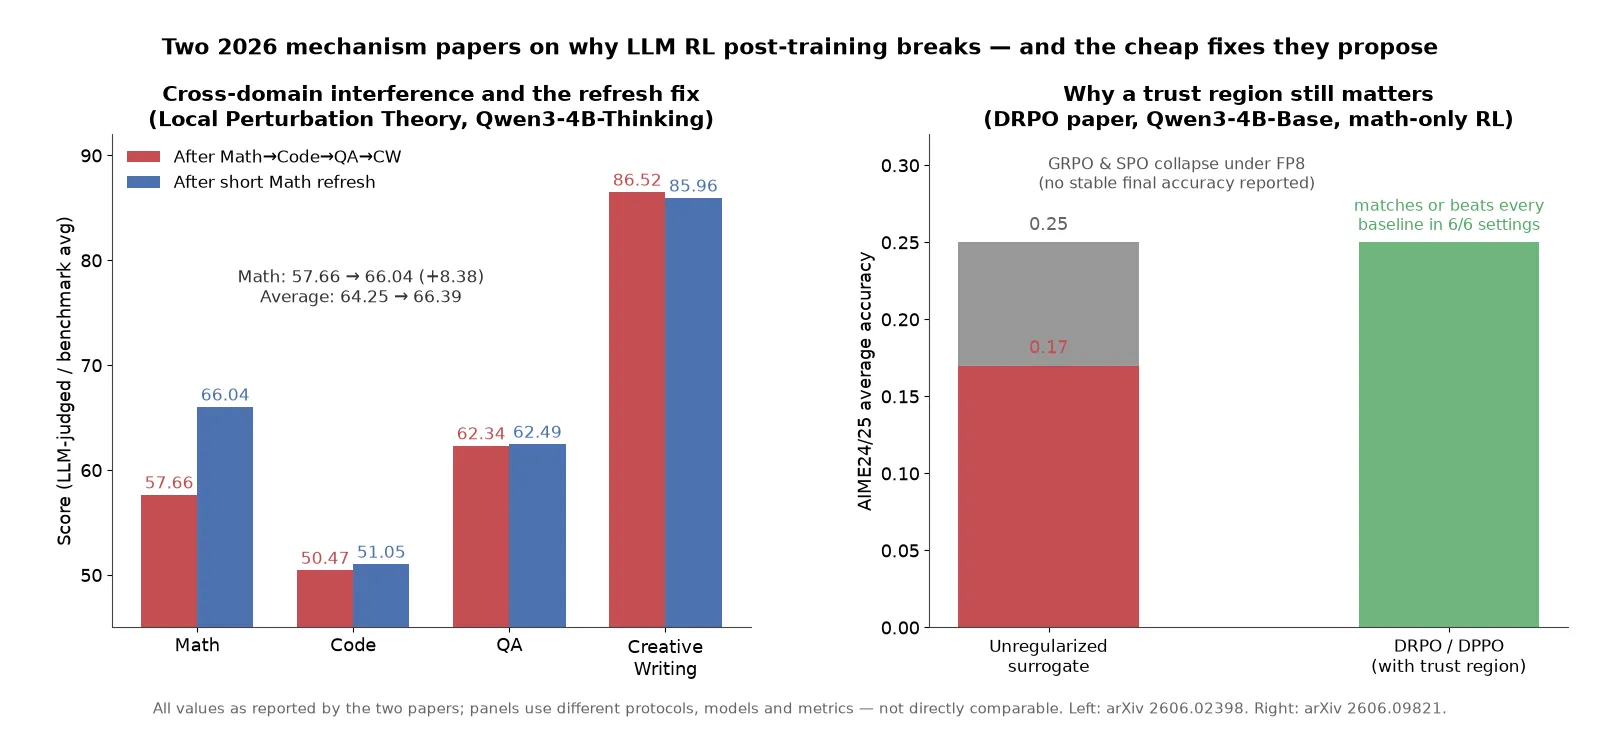
DRPO 把 DPPO 的硬遮罩换成平滑的 Binary-TV 权重,6 个设置(含 FP8)全部稳定;局部扰动理论证明顺序多域 RL 的遗忘来自二阶冲突子空间,短复习可找回大部分能力。
「训练不稳」其实是两种病
「RL 训练不稳定」这句话至少掩盖了两种完全不同的故障,修法也不能互相顶替。第一种发生在单次训练内部:策略偏离产生 rollout 的行为策略,重要性比在稀有 token 上失真,训练要么崩溃要么停在半空。这是 DRPO 的地盘,它重做的是信任域如何塑造每个 token 的梯度权重。第二种发生在多次训练之间:先拿数学做 RL,再跑代码、问答、创意写作,最早学的数学在悄悄退化。这是 局部扰动理论 的地盘,它把遗忘的机制讲清楚,并验证了两个便宜修法。
两篇论文的思路是同构的:先测量一个大家都默认没问题的量,发现真正的损伤被它藏住了,再给出一个不动训练管线的修复。两篇互不跑对方的实验,所以本页把两组数字分栏陈列,绝不拿它们做正面对打。
DRPO 修什么:单次更新内部的几何
LLM 的 RL 在实践中几乎都是离策略的:rollout 来自推理引擎,数值和训练引擎不一致,轨迹又被切成多个 mini-batch,被更新的策略从来不是生成数据的那个。PPO 和 GRPO 用逐 token 重要性比上的裁剪来控制漂移,而 DRPO(承接 DPPO 与 Qi 等人的论点)认为,在长尾词表上,比率是真实分布漂移的糟糕代理:稀有 token 上一点点绝对概率变化就会放大成巨大的比率变化,比率信任域对尾部噪声反应过度,对真正有质量的地方却反应不足。
尾部不是含糊带过,而是量出来的:在 Qwen3-30B-A3B-Base 上,行为概率不高于 0.01 的 token 占全部采样 token 的 7.8%。SPO 的逐 token 梯度权重按行为概率的倒数放大,沿低概率轴无界增长;DRPO 直接惩罚绝对概率偏移(Binary-TV 上的平方 L2),该量天然落在 [0,1],梯度权重方差不超过 1/4,有界性就是整个设计。
DPPO 已经用基于散度的遮罩替换了比率裁剪,但遮罩是硬开关:token 一旦越过边界,梯度直接被清零。DRPO 保留边界、平滑响应:权重在阈值处连续衰减到零,越界后变号、把策略往回拉,朝行为政策方向的更新反而被放大。两个消融撑起证据:Mask-DRPO(边界内用 DPPO 梯度、边界外用 DRPO 修正信号)与完整 DRPO 打平,说明收益主要来自信任域之外的修正信号,而不是域内梯度的重塑;拿掉绝对 advantage 因子,SPO 和 DRPO 都会稳定掉分,因为这个因子让边界不随奖励尺度漂移。正则阈值取 12.5,敏感性分析放在附录。
局部扰动理论修什么:多次训练之间的干扰
顺序多域 RL 遗忘的标准叙事是「梯度冲突导致灾难性遗忘」。本文直接测量这个叙事,发现它是空的:数学与问答的全局梯度余弦接近零,教科书级的「无冲突」条件,但在数学之后继续训代码、问答、创意写作,数学分数在 Qwen3-4B-Thinking 上从 RL 后的峰值 66.49 一路掉到 57.66。图 1 在模块层面解开了悖论:注意力与 MLP 层级上同时存在一个最冲突模块和一个最协同模块,两者在全局平均里相互抵消。干扰不是不存在,是被聚合藏住了。
两个测量锚定机制。其一,RL 后训练的改动稀疏且极小:对每个单域专家,77% 到 89% 的参数绝对变化小于 1e-7,相对变化低于 1e-3。其二,各域「改动最大的神经元」几乎不重叠(Jaccard 重叠低于 0.19),但推理时真正激活的神经元在三个推理域之间高度重叠。各域写到不同的地方,却读经相同的路径,所以两次几乎不相交的更新仍会在共同依赖的路径上撞车。
把先学域的损失围绕扰动参数做二阶展开:一阶项由近正交梯度主导,很小;损伤主要来自二阶项(曲率乘更新方向),并且在实测的稀疏路径结构下集中在一个低维共享冲突子空间里。这个集中性是可检验的:按路径冲突准则只回滚 2% 的 MLP 神经元,就找回 20.4% 的数学损失(59.90 回到 61.25),问答只动了负 0.06;把回滚扩到 32% 的 MLP 与注意力联合分量,恢复率达到 73.6%。论文给从业者的推荐比回滚更简单:在序列末尾补一小段数学 RL。数学从 57.66 回到 66.04,代码 50.47 到 51.05,问答 62.34 到 62.49,创意写作 86.52 到 85.96,平均分从 64.25 升到 66.39。作者自己交代的保留是:复习本质是对数据的再次暴露,更接近排练而非参数空间的手术,所以回滚实验才是对理论更干净的检验,尽管恢复量更少。
关键数字
| 维度 | DRPO(arXiv 2606.09821) | 局部扰动理论(arXiv 2606.02398) |
|---|---|---|
| 故障模式 | 单次训练内的离策略漂移,FP8 下最重 | 顺序多轮训练之间的跨域干扰 |
| 被否定的标准说法 | 比率裁剪是合格的信任域 | 遗忘等于全局梯度冲突 |
| 证据模型 | Qwen3-4B-Base、Qwen3-30B-A3B-Base、Qwen3.5-35B-A3B-Base、R1-Distill-Qwen-1.5B | Qwen3-4B-Thinking-2507,评委 Qwen3-235B-A22B-Instruct-2507 |
| 标志性损伤数字 | 无正则替代目标在 Qwen3-4B-Base 上 AIME24/25 均值 0.25 跌到 0.17 | 数学在数学、代码、问答、写作序列后 66.49 跌到 57.66 |
| 损伤藏在哪 | 7.8% 采样 token 的行为概率低于 0.01 | 共享低秩冲突子空间上的二阶项 |
| 机制 | Binary-TV 上平滑 advantage 加权二次项,方差至多 1/4 | 共激活路径上的曲率乘更新方向 |
| 便宜修法 | 直接替换逐 token 梯度权重,阈值 12.5 | 序列末尾补一段短域复习 |
| 修法收益 | 6 个设置(含 FP8-E2E)全部追平或超过基线 | 数学 57.66 回到 66.04,平均分 64.25 到 66.39 |
| 修法副作用 | 未报告;Mask-DRPO 消融定位了收益来源 | 代码 +0.58,问答 +0.15,写作 -0.56 |
| 免数据修复 | 无 | 回滚 2% MLP 神经元恢复 20.4%(59.90 到 61.25);32% 联合回滚 73.6% |
| 基准范围 | 仅数学,约 13K 题过滤 DAPO 子集 | 数学、代码、问答、创意写作,单一顺序 |
左右两栏的任何一格都不能互比:模型、任务、指标、评委全不同,本页刻意把它们分开。可比的是论证的形状:两篇都测了一个领域默认没问题的量(比率信任域、全局梯度余弦),发现它藏住了真实损伤,然后给出不动训练管线的修法。
怎么选
- 单次 RL 训练不稳或中途停摆,尤其是 FP8 rollout 或 MoE 模型: 先看 DRPO。论文设置里 GRPO 和 SPO 在低精度下崩溃,DRPO 能稳定训完,且改动只是替换逐 token 梯度权重,不需要新 rollout 管线。如果你一直在 BF16 稠密模型上训练且从不掉稳定,预期收益有限。
- 顺序跑多个领域冲掉了先学的域,又没法合并数据: 先看局部扰动理论的复习排程,给最老的域留一小段收尾训练;本研究中其他三个域的代价都在一分以内。
- 完全不能动数据流: 冲突子空间回滚是免数据的选项,2% 的 MLP 神经元换回 20.4% 的损失恢复,32% 联合回滚达到 73.6%,代价是需要论文里的路径冲突诊断,而复习不需要。
- 从零挑选 RL 目标函数: 这两篇都不是干这个的。先选定 GRPO 或某个信任域变体再来读它们;目标函数层面的对照,从 PPO 基线 和 flow-DPPO 所在的信任域家族看起。DRPO 在不可验证的聊天式奖励上表现如何、域内稳定器与跨域干扰如何相互作用,都还是开放问题。
局限与存疑
DRPO 的 AIME24/A25 准确率以训练曲线呈现,正文没有逐设置数字表,对 DPPO 的优势只能表述为「追平或超过」而非引用具体差值,也没有算力或 wall-clock 核算;基准全是带规则验证的数学题,对聊天 RLHF 和智能体任务无话可说。局部扰动理论压在单个 4B 模型、单一域顺序上,冲突子空间在 70B 规模、更多域或换课程后是否仍低维未经检验;其二阶分析假设扰动很小,对激进 RL 的大幅策略漂移可能失效。最有意思的开放问题在两篇之间:DRPO 稳住一次训练,局部扰动理论愈合一段序列,二者叠加时域内稳定器会减少还是重新分配跨域干扰,没人测过。
常见问题
GRPO 在 FP8 下崩了,该先读哪篇?
DRPO。它的核心证据就是:GRPO 与 SPO 在低精度设置里崩溃(FP8 叠加 MoE 架构拉大了训练与推理的数值差异),而 DRPO 在全部六个设置里追平或超过每个基线。修复只改逐 token 梯度权重,可以直接嵌进现有 GRPO 代码库。
局部扰动理论里的「数学复习」和重训有什么区别?
它是在完整的数学、代码、问答、创意写作序列之后,对数学补跑的一小段额外 RL,不是从头再来。数学从 57.66 恢复到 66.04,其他三个域变动都不足一分,表现为选择性恢复而非粗暴排练;不过作者也承认,它本质上仍是对数据的再次暴露。
冲突子空间回滚能不能完全不用数据就修好遗忘?
部分可以。按路径冲突准则回滚 2% 的 MLP 神经元,能恢复 20.4% 的数学损失,问答只动负 0.06;32% 的 MLP 加注意力联合回滚能把恢复率推到 73.6%。两条路都免数据,但恢复量都不如复习,而且都依赖论文里的诊断来选神经元。
DRPO 的信任域和比率裁剪到底差在哪?
比率裁剪约束的是逐 token 重要性比,在稀有 token 上会爆炸:绝对概率的小幅移动变成比率的大幅跳变。DRPO 直接惩罚 Binary-TV 上的绝对偏移,这个量天然有界([0,1]),梯度权重方差不超过 1/4。平滑二次项在边界之外还会继续往回修正,而硬遮罩越界就彻底失语;Mask-DRPO 消融显示,主要收益正来自这段修正信号。
两个修法能不能叠加:每次训练用 DRPO,跨域用复习?
未知。两篇论文没有共享的测试台、模型或任务,也都没测过组合。一个值得做的实验是:如果 DRPO 让域内更新更贴紧行为策略,局部扰动理论测到的二阶损伤也许会缩小,也许会进一步集中。把叠加当假设,别当建议。