DDPM 与 ControlNet 对比:生成引擎和方向盘
DDPM 从零训练生成器,用逐步去噪打败 2020 年的 GAN;ControlNet 冻结已有模型,只训练零卷积连接的副本来实现构图控制。两者是同一技术栈的上下两层。
为什么把这两篇放在一页
DDPM 和 ControlNet 不是对手,这一页也不打算硬凑竞争关系。DDPM(Ho、Jain、Abbeel,2020 年)回答一个问题:不靠对抗训练,怎么从零训练出一个高质量的图像生成器?ControlNet(Zhang、Rao、Agrawala,2023 年)回答另一个问题:面对一个重训不起的生成器,怎么让它服从草图、深度图或人体姿态?今天线上跑的图像生成系统,几乎全都是 DDPM 的思路装在 ControlNet 的壳里。把两层放在一起对照,才能看清每一层到底花多少钱、买到什么,这正是 Builder 点开这一页真正想问的事。
DDPM 立下了什么
DDPM 把一个老想法(逐步加高斯噪声)真正训好了。前向过程在 T = 1000 步里一点点加噪声,直到图像变成纯噪声,这一段是固定的,没有参数。反向过程是训练一个网络,每次只回退去噪一步,从纯噪声开始连跑 1000 次,就得到一个样本。两个决定起了关键作用。第一,因为每步前向都是高斯,可以一步到位跳到任意噪声档位,所以训练每个样本只需随机抽一个 t。第二,不走带逐步权重的完整变分下界,而是让网络直接预测被加进去的那份噪声,用朴素的均方误差训练,也就是 L_simple 目标。这个目标等价于多噪声尺度下的去噪分数匹配,这也是这篇论文把扩散模型和 score-based 路线接通的原因。
回报是样本质量。无条件 CIFAR-10 上,DDPM 拿到 9.46 的 Inception score 和当时最强的 FID 3.17,压过同期的 GAN;256x256 LSUN 上追平 ProgressiveGAN。弱点也写在同一篇里:采样要按顺序跑满整条 1000 步链,比 GAN 一次前向慢几个数量级;似然值又打不过专门的密度模型,所以它是更好的采样器,不是更好的压缩器。条件化、引导、快速采样都是后来的事。DDPM 给你的是引擎,烧的燃料很直白:一大堆干净图像和大量顺序去噪调用。
ControlNet 补上了什么
到 2023 年,引擎已经以 Stable Diffusion 的形式存在,预训练吃了 web 规模的图文对,新的痛点是控制。文本提示擅长内容、不擅长布局:「这个姿势、这条地平线、这栋楼的外轮廓」没法可靠地写进提示词。显而易见的修法是在(条件,图像)配对数据上微调整个模型,但这条路走不通:配对数据集很小,十亿级参数模型在小数据上全量微调,会毁掉你想保留的预训练能力。
ControlNet 的解法是结构性的。冻结现成的 Stable Diffusion 权重,把编码块克隆一份可训练副本,两头用初始化为精确零的 1x1 卷积接上。训练第零步时控制分支什么都不输出,合起来就是原模型本模,训练不可能从破坏它开始;梯度回传后,零卷积的权重慢慢长大,条件信号逐渐渗入。因为底座冻结,梯度不过底座,训练一个可用的控制适配器便宜到单张 GPU 就能做。
关键数字
两篇论文相隔三年,回答的问题不同,所以下表多数行是「不同的尺子」而非同场竞技。最后一列标明哪些数字同口径、可以直接比。
| 测量项 | DDPM(2020) | ControlNet(2023) | setting 与出处 | 同口径? |
|---|---|---|---|---|
| 各自贡献 | 从零训练的无条件生成器 | 冻结底座上的空间控制适配器 | 两篇的设计本身 | 不适用 |
| 代表性质量数字 | CIFAR-10 FID 3.17、Inception 9.46 | Fill50k 人工排序质量 4.22、保真 4.28(1 到 5 分,越高越好) | DDPM 实验表;ControlNet 表 1,用户排序 | 否,任务和指标都不同 |
| 采样/推理成本 | 每张图 1000 次顺序网络前向 | 照常一次去噪流程,外加条件预处理器 | DDPM 第 3 节;ControlNet 设计 | 否 |
| 训练数据量级 | 类别级数据集(CIFAR-10、LSUN 房间) | 5 万以下配对图像稳定,可扩展到 100 万以上 | DDPM 实验;ControlNet 摘要 | 否 |
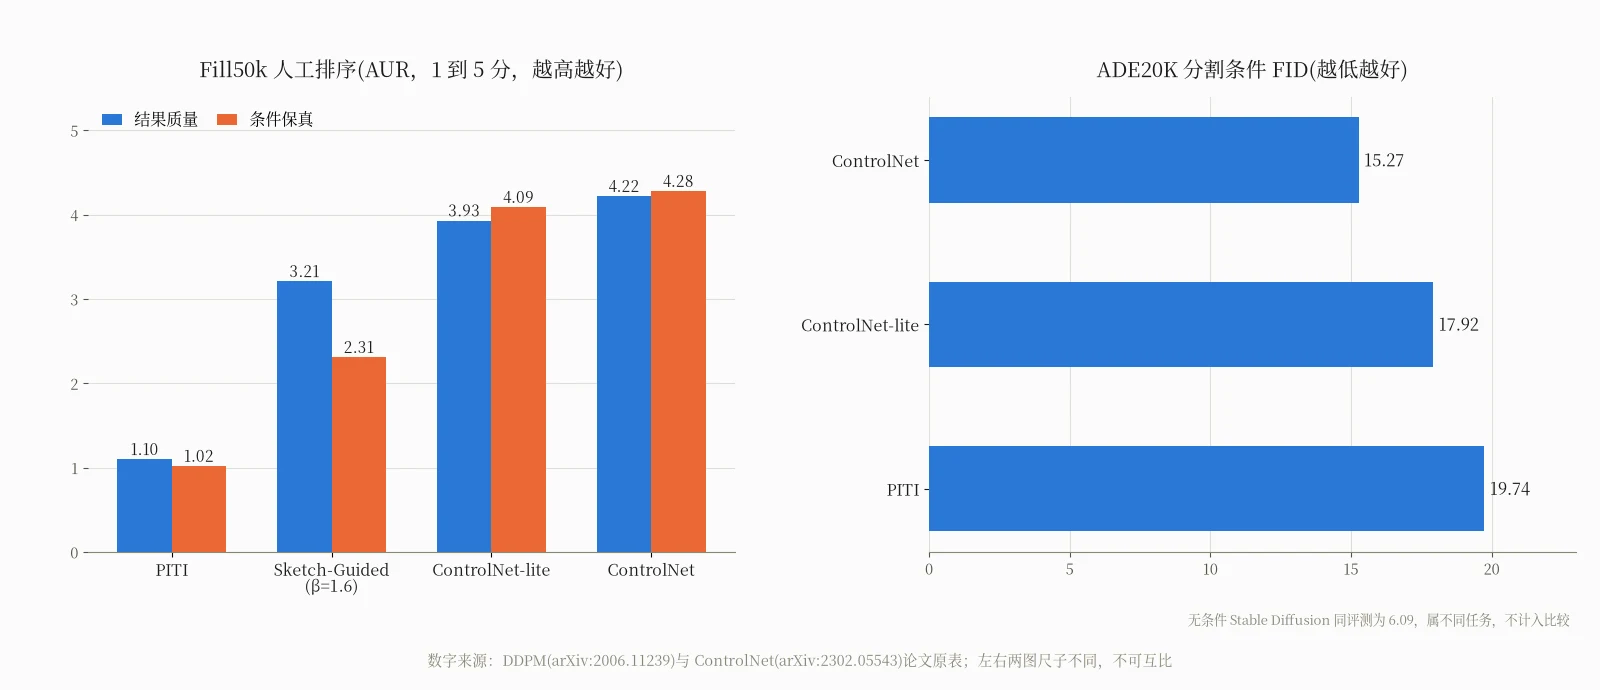
| 与早期草图方法的对比 | 无此项 | 人工排序质量/保真:ControlNet 4.22/4.28,ControlNet-lite 3.93/4.09,Sketch-Guided(β=1.6)3.21/2.31,PITI 1.10/1.02 | ControlNet 表 1,Fill50k,用户 1 到 5 排序 | 是,全部行同一 Fill50k 协议 |
| 分割条件 FID | 不适用 | ControlNet 15.27,ControlNet-lite 17.92,PITI 19.74(越低越好) | ControlNet 表 3,ADE20K 分割图,512x512 集合 | 是,加条件方法同评测;无条件 Stable Diffusion 的 6.09 是另一任务,不算 ControlNet 输 |
| 适配器的额外训练成本 | 不适用,没有适配器 | 单张 A100 40GB 上,比直接优化 Stable Diffusion 多约 23% 显存、多 34% 的单轮时间 | ControlNet 第 4.1 节 | 是,同硬件对比 |
| 对齐工业级深度模型 | 不适用 | 深度 ControlNet:20 万样本、单张 RTX 3090Ti、训 5 天;SDv2-D2I 用大集群 A100、1200 万以上图像 | ControlNet 第 4.1 节与工业模型对比 | 否,成本口径不同 |
| 人眼能否分辨两者 | 不适用 | 12 名用户判别准确率 0.52 ± 0.17,等于瞎猜 | ControlNet 第 4.1 节,先看 100 张样例再测 200 张 | 是,同一用户实验内部 |
这张表给不了的东西也值得一说。不存在 DDPM 和 ControlNet 同场竞争的基准,因为它们在栈的不同层上。DDPM 的 3.17 是从零训练生成器的样本质量声明;ControlNet 的 15.27 是被分割图约束的图像的分布声明,论文自己指出无条件 Stable Diffusion 在同一评测上拿 6.09,只是因为自由生成的分布更容易对齐。这些数字绝不能读成 DDPM 赢了或输了 ControlNet。
每一层到底买到什么
DDPM 买到的是一套训练配方。它的贡献在于:固定噪声调度上的简单噪声预测目标,能在样本质量上打败对抗训练,还没有判别器、没有模式坍塌。代价在推理端:采样器就是模型顺序跑 1000 遍,后来所有加速技巧(减少步数、蒸馏、潜空间化)都是为了填这条开销。
ControlNet 买到的是先验保全。它的贡献是给一个你重训不起的模型加能力的办法:冻结分支保住 web 规模预训练教会的所有东西,可训练副本只学读新条件。零初始化卷积是承重的细节,论文消融显示换成普通初始化效果变差。代价是按条件收税:每类条件(边缘、深度、姿态、分割、涂鸦)都要单独训一个 ControlNet、配一个现成的预处理器,而控制质量的上限就是预处理器质量的上限。
这样看两篇是互补的两笔预算。DDPM 决定引擎是什么;ControlNet 决定你要碰它多少。后来的系统,从 DALL-E 2 起,都是两层叠着用:DDPM 式扩散引擎装在更大的管线里,外面再套条件机制。
怎么选
- 在研究或亲手训练生成器本身:先读 DDPM 配方。前向加噪、任意噪声档位一步到位、L_simple 噪声预测目标,至今仍是每个扩散系统默认你懂的底层模型。
- 已有预训练文生图模型、需要布局控制:用 ControlNet 的模式。冻结底座,训一个零卷积连接的副本,每类条件预算一个适配器。
- 配对条件数据集很小(几万张量级):这正是 ControlNet 的甜区;在那里全量微调底座才是会输的选项。
- 愁的是采样步数太多、服务成本高:问题出在 DDPM 这一层(少步采样器、蒸馏),控制适配器治不了它,因为 ControlNet 的钱花在训练期,不在每个样本上。
- 要的是语义而非结构:ControlNet 管的是几何。「物体不对、风格不对」是底座的提示词或微调问题,边缘图救不了。
局限与存疑
这个对比本身有个结构性缺口:两篇论文任务不同、指标不同、硬件口径不同,所以上表每行都标了是否同口径,只有 ControlNet 内部的行(用户排序、分割 FID、单轮开销)支持直接比较。DDPM 的数字也是 2020 年的:CIFAR-10 的 3.17 说明不了现代文生图的质量,1000 步采样也已被后来的采样器砍到几十步。ControlNet 的小数据稳定性以冻结底座存在为前提,上游预训练成本它一概不省;每个条件的适配器还继承底座全部偏差,一个也不修。两篇都没回答的开放问题是:适配器什么时候该用 ControlNet 式的结构副本、什么时候该用更轻的参数高效方法,这取决于你的条件离底座已理解的东西有多远。
常见问题
DDPM 和 ControlNet 的根本区别是什么?
DDPM 是从零训练图像生成器的方法,把逐步加高斯噪声的过程倒过来学;ControlNet 是给已训好的扩散模型加空间控制、且不必重训它的方法。一个造引擎,一个掌方向。
ControlNet 的零卷积方法是如何工作的?
零卷积是权重和偏置都初始化为零的 1x1 卷积,围在冻结模型编码块的可训练副本两头。初始化时它什么都不输出,网络表现等同原始预训练模型;训练推进后它逐渐放权,让条件信号一点点渗进来。
两篇论文各自报告了什么结果?
DDPM 报告无条件 CIFAR-10 上 FID 3.17、Inception 9.46,256x256 LSUN 质量追平 ProgressiveGAN。ControlNet 报告 Fill50k 用户排序质量 4.22、保真 4.28,ADE20K 分割条件 FID 15.27,以及单张 A100 上每轮训练多约 23% 显存、多 34% 时间。
ControlNet 需要很大的训练数据集吗?
不需要。论文证明 5 万以下配对图像也能稳定训练,并展示方案能扩展到 100 万以上。零初始化连接层正是小数据训练不伤害冻结底座的原因。
DDPM 采样为什么慢?ControlNet 会让它更慢吗?
DDPM 的生成方式是每个去噪步跑一次网络,原文要顺序跑 1000 次。ControlNet 几乎不改变推理成本:只多一个预处理步骤(边缘检测、深度网络、姿态估计),并在每次去噪调用里注入条件,它的开销在训练期。
ControlNet 能用在 Stable Diffusion 以外的模型上吗?
架构是通用的:锁定任何大型扩散模型的编码块,克隆一份,用零卷积接上即可。论文在 Stable Diffusion 上实现,同一模式后来也迁到了其他扩散底座和图像以外的条件场景。