
RL 中的自蒸馏:AntiSD、SDPG、SDAR 对比
同一模型用看不到的上下文教自己:AntiSD 反奖励分歧(最高 +11.5 分),SDPG 蒸馏答案提示教师(AIME25 0.327 对 0.242),SDAR 逐 token 门控。
同一个技巧,和关于它符号的争论
这三篇方法都建立在同一个观察上:RL 训练出的大模型知道的比奖励函数透露的多,只要让同一套权重看一眼部署时永远拿不到的额外信息,就能把这部分知识挤出来。教师不是更大的模型,就是策略自己,只是多看了一份特权上下文:部分解答(AntiSD)、 ground-truth 答案加参考解法(SDPG),或从过往经验里检索到的技能(SDAR)。因为师生同权重,蒸馏目标每步只多一次前向,不需要第二个模型。
三篇真正的分歧在损失函数的符号。经典自蒸馏是最小化师生分歧:把策略往特权分布上拉。AntiSD 的核心论点是这个方向反了。它的诊断显示,普通自蒸馏恰好锐化了错误的 token:给换行、“Step”这类结构性套话抬信心,却压平了真正在权衡选项的斟酌 token 的分布。所以 AntiSD 干脆最大化分歧,用逐 token 的点互信息(PMI)奖励高信息 token。SDPG 和 SDAR 留在经典的最小化一侧,它们要解决的是 AntiSD 所反应的失效模式:不加约束地向教师蒸馏会让策略熵崩塌。SDPG 自带的基线 RLSD 在约 250 步时 actor 熵就崩了;SDAR 的测量显示 multi-turn 轨迹里超过一半 token 上教师比学生还差。同一个技巧,一个翻转符号,两种防止教师毁掉学生的答案。
三篇论文互相都没有评测过对方,下面的表是三份独立证据,不是同场竞技。三者共同的基础算法见 GRPO vs PPO。
关键数字
| 测量项 | AntiSD | SDPG-UFKL | SDAR | 设置与来源 | 同口径? |
|---|---|---|---|---|---|
| 教师信号符号 | 最大化分歧(PMI 奖励) | 最小化对教师的前向 KL | 最小化 KL,逐 token 门控 | 各论文方法 | n/a |
| 特权上下文 | 题目+部分解答(自建) | ground-truth 答案+Gemini 2.5 Pro 解法 | 从历史经验检索的技能 | 各论文 | n/a |
| 头条增益 | 比 GRPO 最高 +11.5 分 | 比 GRPO last-checkpoint +0.100(AIME24)/+0.085(AIME25)/+0.144(AMC23) | 7B 上三个智能体基准 +4.7~+10.2 | 各论文 | 否 |
| 样本效率 | 达到 GRPO 精度省 2-10 倍步数;Qwen3-8B/HMMT25 约 1/5 步数到峰,最终约 +15 | 约 50 步内拉开差距,早数百步到达更高平台 | 不是该论文重点 | 各论文 | 否 |
| 数学基准 | AIME 24/25/26、HMMT25、MinervaMath;HumanEval+/MBPP+ | AIME24/25、AMC23 | 无(只做智能体) | 各论文 | 否 |
| 智能体基准 | 无(只做数学) | 无 | ALFWorld、Search-QA、WebShop | 各论文 | 否 |
| 防崩塌机制 | 熵门:教师熵低于热身基线 0.93 倍时关闭奖励 | 参考 KL(alpha=1e-3)+蒸馏权重衰减+正优势门控 | 逐 token 师生差距 sigmoid 门控 | 各论文 | n/a |
| 最强单点 | Qwen3-8B HMMT25:约 +15 分 | Qwen3-4B AIME25:0.327 对 0.242 | Qwen3-1.7B WebShop:38.3 → 58.6 | 各论文 | 否 |
AntiSD:奖励教师不同意的地方
AntiSD逐 token 计算下一个 token 与特权上下文(题目加提示或部分解答)之间的点互信息。特权上下文改变了分布的地方,token 携带信息;没改变的地方就是结构性的。普通自蒸馏最小化这个差距,按论文的诊断,等于把梯度花在换行和”Step”套话上,同时压平斟酌 token。AntiSD 翻转目标,通过有界的整形函数 phi(u) = 0.5 * (softplus(u) - log 2) 最大化差距,下界钳在 -0.5 * log 2,不让探索性 token 被罚得没有上限。
工程核心是一个熵触发的门。5 步热身标定基线教师熵 H_warm,教师熵一旦跌破 0.93 * H_warm,PMI 奖励自动关闭(教师已经很自信,挖不到有用的分歧了),熵恢复时再打开。论文报告,在 4B 到 30B 的五个模型上(Qwen3-4B-Instruct-2507、Qwen3-8B、Qwen3-30B-A3B、OLMo-3-7B-Instruct、OLMo-3-7B-Think),AntiSD 用 2 到 10 倍更少的步数达到 GRPO 基线精度,最终最高多 11.5 分;最强单点是 Qwen3-8B 在 HMMT 2025 上约 1/5 步数到达 GRPO 的峰值,最终高约 15 分。
诚实的保留意见是覆盖面:全部在数学推理上,这是特权部分解答最好构造、正确 token 最好定义的区间,而且 0.93、5 步热身这些常数读起来是调出来的。但换来的是它不依赖任何外部教师数据,特权上下文自己就能造。
SDPG:能活下来的全词表蒸馏
SDPG留在经典的最小化方向,用正则而不是翻符号来解决崩塌。教师看到的是模板化提示:正确答案是 {answer}。一种常见解法是: {solution},其中解法来自 Gemini 2.5 Pro。损失是逐 token 对整个词表求和的在策略蒸馏 KL(表现最好的变体 UFKL 用未归一化的前向 KL),叠在组相对验证器优势(带归一化标准差)之上,再加一个系数 alpha = 1e-3 的参考策略 KL。
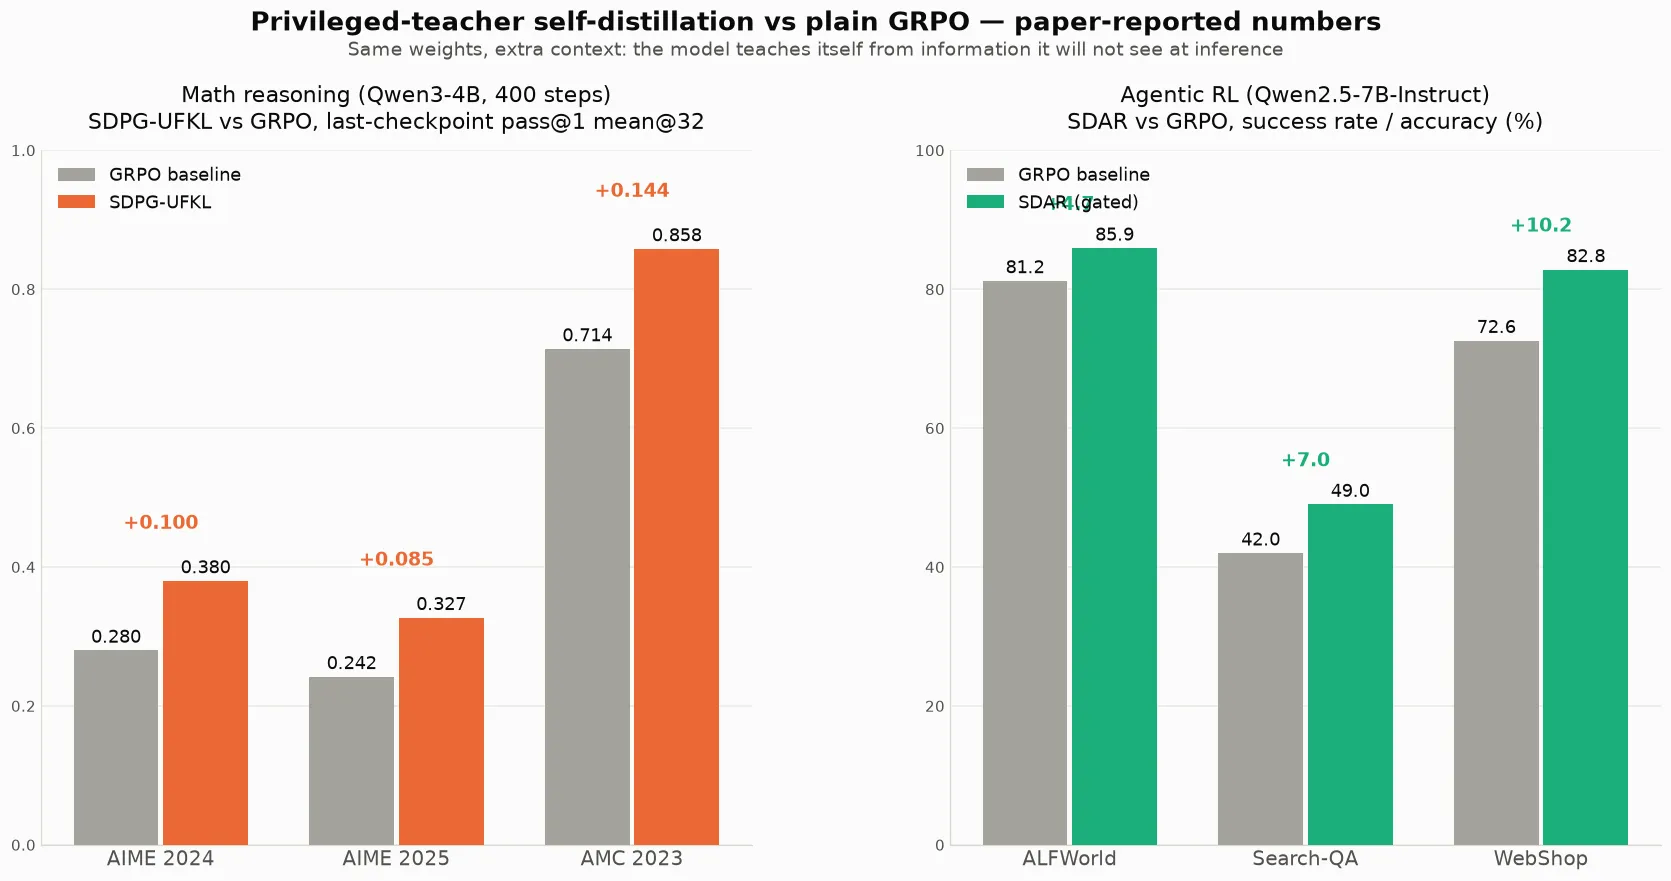
三个旋钮让蒸馏不失控。正优势门控只在验证器判对的轨迹上施加蒸馏损失,防止尖锐但不完美的教师在全局错误的路径上强化貌似合理的 token。beta 调度把蒸馏权重先升温、保持、再衰减,把学生在测试时拿不到的信息逐步退出去。参考 KL 则是 SDPG 和它自己的消融基线 RLSD 的分界线:RLSD 从同一特权教师蒸馏,但 actor 熵在约 250 步时崩塌。Qwen3-4B 训 400 步(pass@1,mean@32),SDPG-UFKL last-checkpoint 在 AIME 2024 达 0.380(GRPO 0.280),AIME 2025 达 0.327(GRPO 0.242),AMC 23 达 0.858(GRPO 0.714)。KL 方向是真正的调参轴:AIME 2025 last 上反向 KL(URKL)只有 0.307,UFKL 是 0.327。
代价是数据依赖:与 AntiSD 不同,SDPG 需要每道训练题都有已验证答案和外部参考解,所以它是「手里已有参考答案时的微调方法」,不是从零吃验证器信号的方法。
SDAR:蒸馏是带门控的帮手,不是副驾
SDAR把同一个技巧搬到 multi-turn 智能体上,这里的失效模式更严重。教师是同策略加上从历史经验检索到的技能(学生推理时看不到),而在 GRPO 上直接加朴素蒸馏会崩,原因有二:师生漂移跨轮累积;检索不完美,超过 50% 的 token 上师生对数概率差是负的,也就是「教师」在这些地方比学生还差。无门控地蒸馏,等于大部分时间都在抄一个更差的教师。
SDAR 的答案是对逐 token 差距做 sigmoid 门控:教师确实更好的地方加强蒸馏,其余地方衰减;RL 仍是主目标(L = L_GRPO + lambda * L_SDAR,报告的甜点 beta = 5.0、lambda = 0.01)。SDAR 对 GRPO 基线的成功率/准确率提升:Qwen2.5-3B-Instruct 在 ALFWorld 75.0→84.4(+9.4)、Search-QA 36.4→43.4(+7.0)、WebShop 63.3→68.0(+4.7);Qwen2.5-7B-Instruct 在 ALFWorld 81.2→85.9(+4.7)、Search-QA 42.0→49.0(+7.0)、WebShop 72.6→82.8(+10.2);Qwen3-1.7B 的 WebShop 从 38.3 跳到 58.6(+20.3),是最大单点提升,但基线也最弱。起作用的是门而不是技能:即使随机检索,增益仍在(ALFWorld +1.9)。
怎么选
三种方法对应三种不同的诊断。如果你的问题是 RLVR 一条轨迹只有一比特信号、且手里已有已验证答案的数学题,SDPG 的路线验证最直接。如果想要样本效率增益又不想依赖外部解答数据,AntiSD 的翻符号加熵门是三篇里唯一自建特权上下文的。如果在训 multi-turn 智能体、有过去经验可检索,SDAR 的逐 token 门控是这里唯一实测过并补偿了「大多数 token 上教师是错的」这一事实的设计。
局限与存疑
上面的头条数字来自三份独立证据:AntiSD 是 4B 到 30B 五个模型上的数学推理,SDPG 是 Qwen3-4B 在三个数学竞赛上配 Gemini 2.5 Pro 参考解,SDAR 是 7B 以内的 Qwen 在三个智能体基准上。三篇两两不同 harness,所以这些数字各自证明「比自己的 GRPO 基线强」,不能排出三者之间的名次。共性的开放问题包括:AntiSD 的门控常数在数学之外有多敏感;SDPG 离开外部参考解后增益还剩多少;SDAR 的「技能已内化」论断在压力测试下是否成立;以及三者的增益能否迁移出 Qwen/OLMo 家族。三篇都不支持无门控版本:每篇的消融或诊断都指向同一个结论,即不向特权同权重教师加门控、调度或 KL 刹车,迟早会锐化错误的 token 或压塌策略的熵。
常见问题
什么是特权教师自蒸馏(AntiSD、SDPG、SDAR 共用的技巧)?
同一个模型既当学生又当教师。教师那次前向多看一份部署时拿不到的上下文(部分解答、标准答案或检索到的技能),让它逐 token 的分布成为稠密且廉价的监督目标,叠加在稀疏的轨迹末端奖励之上。
AntiSD 最大化分歧,SDPG 和 SDAR 最小化分歧,谁对?
它们在回应不同的诊断。AntiSD 的测量表明经典自蒸馏锐化结构性 token、压平斟酌 token,于是改为奖励高信息 token 上的分歧;SDPG 和 SDAR 接受经典方向,改用参考 KL、调度和逐 token 门控解决崩塌和坏教师问题。两者之间没有同场对比。
AntiSD、SDPG、SDAR 各自比 GRPO 强多少?
按各自论文的设置:AntiSD 用 2-10 倍更少步数达到 GRPO 精度,数学上最终最高 +11.5 分;SDPG-UFKL 在 Qwen3-4B 上 last-checkpoint 比 GRPO 高 +0.100(AIME24)、+0.085(AIME25)、+0.144(AMC23);SDAR 在 Qwen2.5-7B 上跨 ALFWorld、Search-QA、WebShop 加 +4.7 到 +10.2。模型、任务、口径各不相同,不是同一份排名。
为什么 AntiSD、SDPG、SDAR 都需要门控或调度?
因为无门控的特权教师损失被证明有害:SDPG 的 RLSD 基线没有 KL 刹车,约 250 步时 actor 熵崩塌;SDAR 在 multi-turn 中测出超过 50% 的 token 师生差距为负;AntiSD 证明经典蒸馏压平的恰是重要的探索 token。门、调度或翻符号是贡献本身,不是调参细节。
一句话:让同一个模型偷看一眼答案,然后在它改变主意的地方给奖励(AntiSD)、带着刹车去蒸馏它(SDPG)、或者只抄它确实对的地方(SDAR)。逐篇细节见 AntiSD、SDPG 和 SDAR 的论文页。