
DeepSeek-R1 和 SU-01 的区别:两条开源推理路线怎么选
R1 证明纯 RL 能教出推理,SU-01 证明 33.8 万条短 SFT 轨迹加 200 步 RL 就能让 30B 开源模型摸到奥赛金牌线;两条路线各花多少、什么时候选哪条。
两条配方,同一个问题
两篇论文从两端回答同一个问题:推理模型到底需要多少监督数据?DeepSeek-R1(2025 年 1 月)把答案往零推:推理阶段不喂人工推理过程,只奖励最终答案对不对,让强化学习自己长出思考。SU-01(2026 年 5 月)把答案往「克制」推:一份配比精心设计的 SFT 数据(约 33.8 万条短轨迹),加上刻意压短的 200 步 RL,就足以让 30B 开源模型在国际数学奥林匹克和国际物理奥林匹克上同时越过金牌线。
两个模型不是同一张榜单上的对手。R1 是建在前沿规模基座上的通用推理模型;SU-01 是竞赛专精模型,目的是证明训练纪律才是瓶颈,而不是规模。这个对比仍然值得做,因为 2026 年任何人在选开源推理方案时,本质上都在这两种哲学之间做选择:靠 RL 涌现推理,还是靠数据设计造出紧凑推理。两者用的 RL 算法都是 DeepSeekMath 提出的 GRPO,也都放开了权重,所以这个对比是具体的,不是空谈。
关键数字
下表每个数字都来自原始论文自报。几乎没有同一口径的数字,表格里明确标注了,而不是把不可比的数字悄悄排在一起。
| 测量项 | DeepSeek-R1 | SU-01 | 设置与出处 | 同一套评测? |
|---|---|---|---|---|
| AIME pass@1 | AIME 2024 79.8% | AIME 2025 94.6%,AIME 2026 93.3% | 各自论文 | 否:不同年份、不同题集 |
| MATH-500 | 97.3% | 未报告 | R1 论文 | SU-01 无此数字 |
| IMO 2025 | 未报告 | 35 分,正好金牌线 | SU-01 论文 | R1 无此数字 |
| USAMO 2026 | 未报告 | 35 分,超金牌线 10 分 | SU-01 论文 | R1 无此数字 |
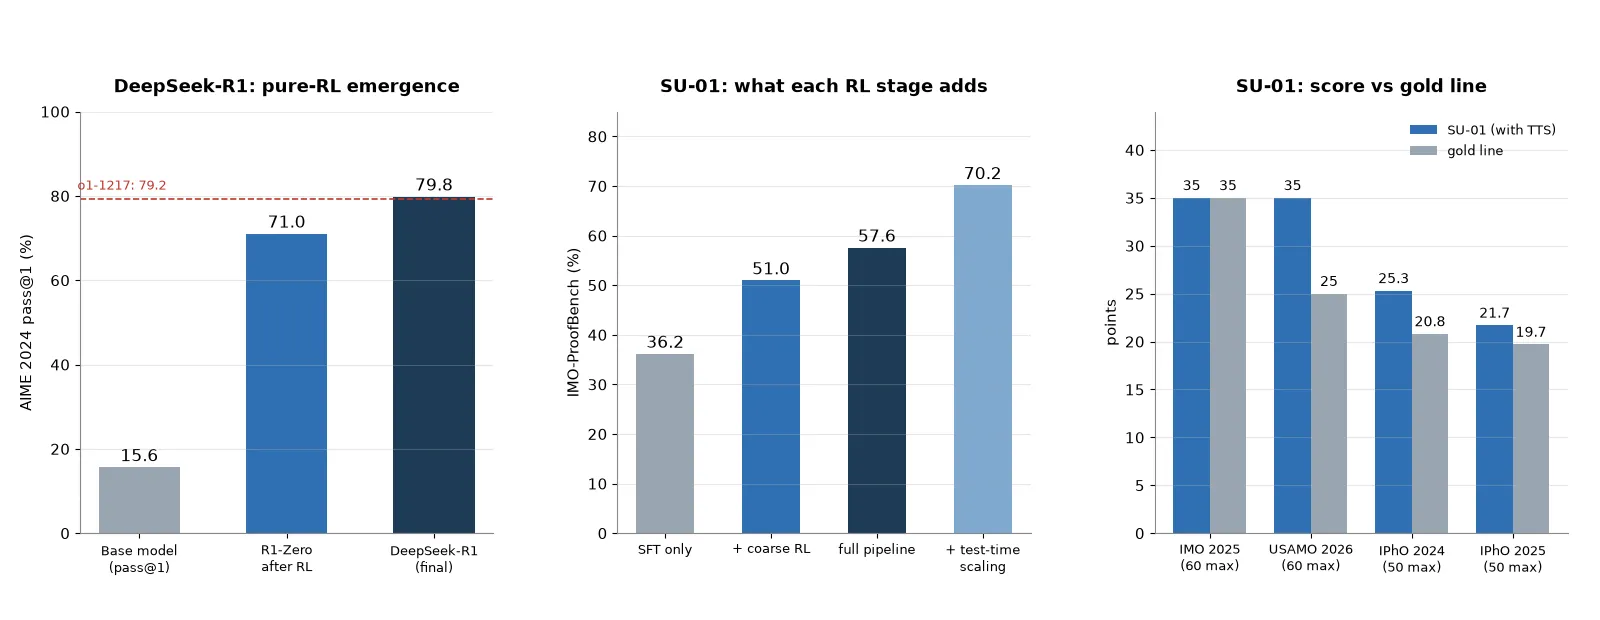
| IPhO(配合测试时扩展) | 未报告 | 25.3 对金牌线 20.8(2024);21.7 对 19.7(2025) | SU-01 论文 | R1 无此数字 |
| IMO-ProofBench 消融 | 未报告 | SFT 36.2,加粗调 RL 51.0,完整 57.6,测试时扩展 70.2 | SU-01 消融表 | 不适用 |
| 纯 RL 的 AIME 涨幅 | 15.6% 涨到 71.0%,多数投票 86.7%(R1-Zero) | 未报告 | R1-Zero,全程无人工推理数据 | 不适用 |
| SFT 数据 | 几千条长思维链冷启动样本 | 约 33.8 万条,每条 8K token 以内,54.3% 直接生成、45.7% 自我提升 | 两篇论文 | 不适用 |
| RL 预算 | 未披露步数 | 共 200 步,96 步粗调加 104 步精调 | SU-01 论文 | 不适用 |
| 基座 | DeepSeek-V3-Base,前沿规模 | P1-30B-A3B,30B 开源模型 | R1 站在 DeepSeek-V3 上 | 不适用 |
| 协议 | MIT,另有 6 个蒸馏小模型(最小 1.5B) | 开放权重,30B-A3B | 两篇论文 | 不适用 |
大家最想先比的那个数字(AIME)恰恰是最不诚实的对比:R1 的 79.8% 是 AIME 2024,SU-01 的 94.6% 是 AIME 2025,两场比赛难度不同。这个格子只能当背景参考,不能当证据。
两条配方各自是什么
R1 配方:涌现优先。 R1-Zero 拿基座模型直接跑 GRPO,用规则化奖励:数学题核对答案,代码跑测试,再加一点格式奖励把思考过程圈进标签里。不用神经奖励模型,也不喂任何人工推理数据。最著名的结果是那条成长曲线:AIME pass@1 纯靠 RL 从 15.6% 涨到 71.0%,加多数投票到 86.7%。产品版 DeepSeek-R1 再补几千条「冷启动」长思维链样本解决可读性,然后大规模 RL、拒绝采样造新 SFT 数据、最后一轮对齐。真正贵的是底下的基座:网上流传的「几百万美元」说的是训练 DeepSeek-V3,不是 R1 的推理阶段。
SU-01 配方:数据设计优先。 SU-01 承认 SFT 必需,转而追问:最小而精的 SFT 集长什么样。约 33.8 万条轨迹每条都压在 8K token 以内,54.3% 是直接生成数据,45.7% 是由自我验证、自我修正轨迹组成的自我提升数据。这个设计赌的是:SFT 教紧凑推理加自我纠错,长度留给 RL 去长。RL 短得惊人:一共 200 步,96 步粗调加 104 步精调。消融表才是论文真正的论点:SFT 单跑 IMO-ProofBench 只有 36.2%,加粗调 RL 跳到 51.0%,完整管线到 57.6%,配上把轨迹推过 10 万 token 的测试时扩展能到 70.2%。
共用的骨架。 两条配方都是 GRPO 加可验证奖励,都开放权重。分歧在于各自把什么当稀缺资源:R1 把人工推理数据当放射性物质,证明只要基座够强,没有它也能走很远;SU-01 把数据配比当主杠杆,证明小而干净的数据集加一段短 RL,胜过海量模仿数据。
怎么选
需要一个数学、代码、STEM 通吃的通用推理模型,而且负担得起前沿规模基座加完整多阶段 RL 管线,选 R1 配方。R1 的成绩面广:MATH-500 97.3%、Codeforces 评分接近 2029,还有蒸馏版(7B 蒸馏模型 AIME 2024 达 55.5%)让普通硬件也能用上这套行为。这条配方的生态也更成熟:MIT 权重、官方蒸馏、两年的社区复现积累。
目标是在训练预算可复现的前提下冲竞赛级数学和物理,选 SU-01 配方。33.8 万条短轨迹加 200 步 RL,这样的管线资金充足的实验室、甚至决心够大的学术组都能重跑;奥赛数字(IMO 2025 拿 35 分,IPhO 两年配合测试时扩展越过金牌线)恰好是竞赛式评测最看重的画像。代价在推理侧:物理金牌成绩依赖 10 万 token 以上的测试时扩展,训练便宜不代表跑起来便宜。
一个实用提醒:两者是互补而不是互斥。SU-01 的数据配比经验(短轨迹、自我提升数据、长度交给 RL)对任何调 R1 式管线的人都有用;R1 的蒸馏 playbook,对任何想把 SU-01 级别推理能力压到 30B 以下的人同样适用。
局限与存疑
- 没有同口径的成绩格。 表里没有一项是两个模型在相同条件下都报了分的,所以任何总排名都是捏造的精度。诚实的比法是配方比配方,不是分数比分数。
- SU-01 的金牌余量很薄。 IPhO 2025 靠测试时扩展才越过金牌线,21.7 对 19.7;竞赛题目数量少,方差是真实存在的。IMO-ProofBench 依赖自动评分,而自动证明评分本身仍有争议。
- R1 的成本故事容易被误读。 便宜的是推理阶段,它踩着的基座是前沿规模训练。端到端复现 R1 不是预算级的事。
- 两条配方都依赖可验证奖励。 数学答案和物理分数能核对,开放式推理不能。两篇论文都没回答这些配方在可验证领域之外能走多远。
- SU-01 的招牌数字藏着测试时扩展。 两个 IPhO 金牌和 IMO-ProofBench 的 70.2% 都来自测试时扩展配置,那是与直接生成完全不同的成本档位。
常见问题
SU-01 的 AIME 94.6% 比 R1 的 79.8% 高,所以 SU-01 更强吗?
不能这么说。SU-01 的 94.6% 是 AIME 2025,R1 的 79.8% 是 AIME 2024,两场比赛题集不同,两篇论文也都没报对方的年份。能确认的是:SU-01 在 IMO 2025 拿到 35 分金牌线,并配合测试时扩展在两年 IPhO 越线;R1 的强项是 MATH-500 97.3%、AIME 2024 79.8% 和接近 2029 的 Codeforces 评分。
SU-01 和 DeepSeek-R1 各用多少 RL?
SU-01 给了精确预算:GRPO 共 200 步,96 步粗调加 104 步精调,消融表显示每一步在 IMO-ProofBench 上加多少(仅 SFT 36.2%,加粗调 RL 51.0%,完整 57.6%)。DeepSeek-R1 没有披露步数;它的 RL 证据是 R1-Zero 的曲线:不喂任何人工推理数据,AIME pass@1 从 15.6% 涨到 71.0%。
DeepSeek-R1 用的 SFT 数据比 SU-01 多吗?
恰恰相反,大概率更少。R1 的冷启动阶段只用几千条长思维链样本,后续 SFT 阶段的数据还是用 RL 模型拒绝采样自己造出来的。SU-01 的初始 SFT 集约 33.8 万条轨迹,不过每条都压在 8K token 以内,按 token 数算两边差距比按条数算小得多。
2026 年小团队应该复现 DeepSeek-R1 还是 SU-01?
纸面上 SU-01 的管线更可复现:33.8 万条短轨迹加 200 步 RL,基座是 30B 开源模型。R1 的推理阶段概念上更简单,但它站在前沿规模基座上,成本大头在那里。无论选哪条,都要给推理留预算:SU-01 的招牌成绩需要 10 万 token 以上的轨迹,R1 之所以要蒸馏这一步,恰恰是因为全尺寸模型跑起来太重。
SU-01 的 IMO 和 IPhO 金牌声明靠谱吗?DeepSeek-R1 有可比成绩吗?
它们是论文自报的竞赛成绩,可信度理应低于基准测试均值。SU-01 的 IMO 2025 是正好 35 分压在金牌线上,IPhO 2025 对金牌线的优势是 21.7 对 19.7,且只在测试时扩展下成立。题目数量少意味着方差大,而且论文对 IMO-ProofBench 依赖自动评分,这套方法学本身仍有争议。