
自动科研智能体对比:AutoResearchClaw、EurekAgent、ARIS
四篇 2026 年的系统从四个层攻同一个问题:工作流(0.648 对 0.419)、环境(85.71% 任意奖牌)、对抗审查,以及度量。
四个系统都在解同一道题
自动科研智能体要做的是初级研究员的活:选题、写代码、跑实验、分析结果、写论文。Demo 看上去都很好,失败模式却出奇一致。AutoResearchClaw 把两类反复出现的失败点名列得很清楚:一是编造根本没算过的结果,二是早期一个错误决定(数据划分错了、指标选错了)悄悄污染后面所有环节。ARIS 又补了第三类,它叫”貌似成功实则无据”:任务跑完了,论文看着完成了,结论却从未被验证过。没有任何地方崩溃,所以一切都显得正常。
这四篇工作分别从四个不同的层攻这个问题。它们不是直接竞品,这正是值得对比的原因:你选哪一层来修,决定了你能拿到什么证据、还会留下什么风险。
同一道题的四个答案
- 修工作流。 AutoResearchClaw 把机器学习研究拆成固定的 23 个阶段、分三个阶段(构思、实验、报告),用 K=3 的智能体小组辩论假设和分析结果,设专门的验证阶段把每个报告数字绑回真正执行过的代码,人可以在任意阶段介入。它的论点:靠结构化流程加一个够得着的人,而不是靠单个更聪明的 agent。
- 造环境。 EurekAgent 不换 agent,而是设计 agent 周围的一切:权限上把隐藏评测器和权威成绩文件挡在工作区之外,用文件系统和 Git 记录充当实验笔记,把时间/API 预算显式化,再给人留监控界面。它的论点:对指标驱动的科学发现,环境工程和 prompt 同样重要。
- 加审查层。 ARIS 是一个开源 harness:Claude 系的执行模型配一个异家模型(GPT、Gemini、GLM、MiniMax、Kimi 或 DeepSeek)的审查者,专职攻击中间产物。上面再叠 65+ 个 Markdown 技能、五条工作流和三段式”证据到结论”审计。它的论点:最危险的是安静的失败,所以要把”没证据就交活”变贵。
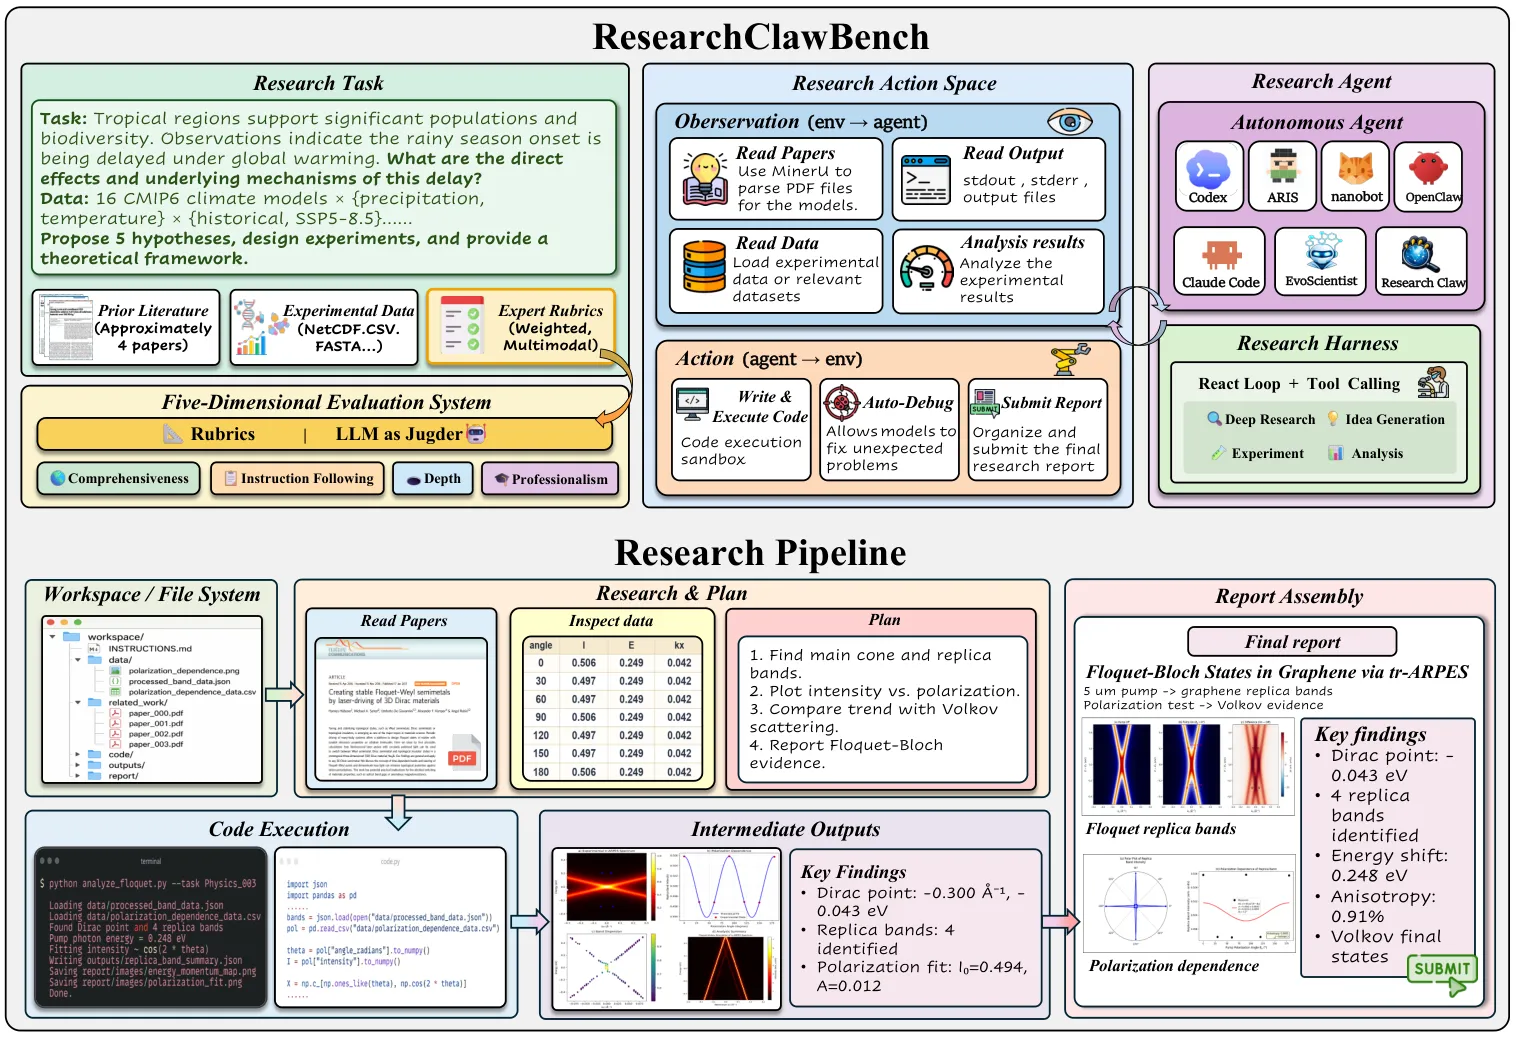
- 先度量。 ResearchClawBench 不是系统,是一个 40 任务的基准,把端到端自动科研变成可判定对错的测试,暴露具体的失败信号。它的论点:没有比普通榜单分数更细的失败剖面,上面所有声称都无法证伪。
关键数字
| 系统 | 修哪一层 | 代表数字 | 基准/场景 | 与对手同口径? |
|---|---|---|---|---|
| AutoResearchClaw | 工作流 + 人在环 | 总分 0.648,对 AI Scientist v2 的 0.419、AIDE-ML 的 0.511 | ARC-Bench,25 个 ML 主题 | 是,自建基准但跑了外部基线 |
| AutoResearchClaw | 结果分析质量 | 0.523 对 0.261,相对提升 100.4% | ARC-Bench 分项 | 是,对 AI Scientist v2 |
| AutoResearchClaw | 全自动 vs CoPilot | 4.03/10、接受率 25.0% 对 7.27/10、87.5%(全程仅 6 次介入) | 10 个主题,表 3 | Step-by-Step:5.19/10、50.0%、23 次介入 |
| AutoResearchClaw | 跨领域宽度 | 物理 0.489、生物 0.912、统计 0.898 | 20 个科学任务(10 高能物理、7 生物、3 统计) | 无对手对照 |
| EurekAgent | 环境工程 | TriMul 中位 2005.03 µs,对 TTT-Discover 的 2247.78、重评榜单最佳 2096.04 | TriMul 算子工程 | 本地重评,非统一榜单 |
| EurekAgent | 数学发现 | 26 圆装填 2.635999;Erdős 最小重叠 0.380870 | 开放猜想类任务 | 新纪录,无同口径对手 |
| EurekAgent | 机器学习工程 | 任意奖牌 85.71%、金牌 71.43%、全部高于中位 | MLE-Bench Lite 7 任务子集 | 子集,非完整 MLE-Bench |
| ARIS | 审查/对抗复核 | 4 轮审查-修改,审查者打分 5.0 → 7.5/10,20+ 次 GPU 实验 | 单次通宵示例运行 | 否,由系统自己的审查者打分 |
| ResearchClawBench | 度量 | 40 个可判定任务,给出具体失败信号 | 端到端自动科研 | 不适用,它本身就是基准 |
看这张表,先看它缺什么。四个系统之间没有共同口径:0.648、85.71%、5.0→7.5 在三套不同协议下量的是三件不同的事。唯一的正面对照行来自 AutoResearchClaw,因为它自建了 ARC-Bench 并把 AI Scientist v2 和 AIDE-ML 都跑了一遍。EurekAgent 的 TriMul 对比是本地重评,MLE-Bench 结果是 7 任务子集;ARIS 的头条数字是单次示例运行、由系统自家审查者打分,它自己的论文页也承认这有循环论证。这些数字不假,但也都不能直接搬。
最重要的数字其实是个”人在环”数字
把架构剥掉,表里最有决策价值的是第三行。全自动模式下,AutoResearchClaw 的产出人工接受率只有 25.0%,平均质量 4.03/10;而人在全程只介入 6 次的 CoPilot 模式就能到 7.27/10、87.5%。一个笨办法 Step-by-Step 在全部 23 个阶段都打断,介入 23 次,结果反而更差(5.19/10、50.0%)。两个结论:其一,人类审查者目前是承重墙;其二,人在哪里介入比介入多少次重要。
这一行重构了整个对比。EurekAgent 的预算告警和监控界面、ARIS 的终端检查、AutoResearchClaw 的 CoPilot,是同一个判断的三种工程表达:今天的自动科研仍是一个有人监督的过程,产品问题只在于监督要多便宜、多早发生。ARIS 把原因说得很透:一个编造出漂亮结果的 agent 比一个大声失败的更糟,因为下游的人会信任那份 polished 的产物。
怎么选
- 你手上有指标驱动的优化任务(算子、装填、Kaggle 式 ML 问题): EurekAgent 的环境工程最可复制。“评测器边界”(agent 可以自由探索,但碰不到隐藏评测器和权威成绩文件)是无论你跑哪个 agent 都能照搬的设计模式。
- 你想要一个给自己团队用的 ML 研究助手: AutoResearchClaw 的证据最可用,因为它是唯一有外部基线的(0.648 对 0.419)。但要按 CoPilot 模式来规划,别按全自动。
- 你在自建自动科研管线: ARIS 的审查层可以单独复用:三段式证据审计和异家审查者模式适用于任何 harness。但它的质量数字只当 demo 看,别当证明。
- 你需要判断这些声称对你的场景成不成立: 这正是 ResearchClawBench 的用途。先拿它的 40 任务失败剖面做诊断,再决定信不信某个榜单数字。
它们都没解决什么
共同的盲区是归约不成标量的证据。EurekAgent 的页面说得很直白:环境工程论点只在有 executable evaluator 的任务上得到展示,而科学里证据缓慢、嘈杂、无法归约成单一分数的大部分领域不在范围内。AutoResearchClaw 的跨领域声称,统计一侧只依托 3 个任务。ARIS 的作者明确说系统”不能保证任何产出正确、新颖或科学上成立”。而且所有系统的验证环节,到某处总会落回一次 LLM 判断:足够自信的模型仍可能通过它本该不过的审查。成本则是全场都没量化的维度:多智能体辩论、异家审查、23 阶段管线都在成倍放大 token 开销,没有一篇把这笔账放到中心。
局限与存疑
这个领域缺一个能定层归属的实验:同一批研究任务,分别跑结构化工作流 harness、工程化环境和审查层,三边都报成本和人工介入时长。在它出现之前,“哪一层最重要”是从四篇论文各自的成功反推的争论,不是测量。也值得再强调一遍:四个头条数字里有三个出自作者自家协议(自建基准、本地重评、自家打分)。这在年轻领域属正常,但相应地要打折采信。
常见问题
哪个自动科研 agent 最强?
没有共享基准能给它们排名,所以不存在站得住的”全能冠军”。AutoResearchClaw 有唯一的正面对照数字(ARC-Bench 上 0.648 对 AI Scientist v2 的 0.419),EurekAgent 的单任务成绩最强(7 任务 MLE-Bench Lite 子集 85.71% 任意奖牌),ARIS 是可复用的审查 harness 而非榜单选手。按你需要修哪一层来选。
AI 能完全自主做科研了吗?
目前质量上还过不了线。AutoResearchClaw 自己的全自动模式平均质量 4.03/10,人工接受率 25.0%;同样是这个系统,人每轮只介入 6 次(CoPilot 模式)就能到 7.27/10、87.5%。
AutoResearchClaw 比 AI Scientist v2 强多少?
在 AutoResearchClaw 的 25 主题 ARC-Bench 上,总分严格口径 0.648 对 AI Scientist v2 的 0.419(相对提升 54.7%),对 AIDE-ML 的 0.511。提升最大的是结果分析维度:0.523 对 0.261,相对提升 100.4%,论文把它归因于辩论加验证的设计。
ARIS 说的”貌似成功实则无据”是什么?
指自动任务跑完、产出 polished 产物、但结论从未被验证的失败模式。没有任何崩溃,所以如果没有审计层,这种失败根本看不见。ARIS 用异家模型审查者和三段式证据到结论审计来对抗它。
EurekAgent 的环境工程具体指什么?
围绕一个现成的 CLI agent 塑造它周围的一切:权限上把隐藏评测器和权威成绩文件隔离在工作区外;用文件系统和 Git 留存历次尝试;显式的时间与 API 预算;给人的监控界面。agent 可以自由探索,但改不了给它打分的评测器。
一句话:2026 年的 AI 科学家系统在诊断上意见一致(agent 会在没做对的情况下交活),在处方上分道扬镳(修工作流、造环境、加审查、做度量),而每个诚实的数字里都留着一个人。延伸阅读:AutoResearchClaw、EurekAgent、ARIS、ResearchClawBench。