
长上下文 · 高效 AI · Transformer
稀疏注意力和全注意力的区别:速度从哪来,质量丢在哪
稀疏注意力在 100 万 token 上把注意力计算量压到 1/7 到 1/28,长上下文基准只掉半分左右;但实际耗时的收益远小于 FLOPs 的收益,32K 以下几乎看不见。
“稀疏注意力”其实是四件不同的事
全注意力让每个查询 token 给之前所有 key 打分,代价随上下文长度平方增长。所有叫稀疏注意力的方法都在减少每个查询接触的 key 数量,但最近几篇论文动手的位置不同,而这个对比里的第四个方法根本不稀疏。
学习索引器做块选择。 MiniMax Sparse Attention(MSA)在每个注意力层前放一个轻量索引分支,给 128 token 的 KV 块打分,保留前 16 块加本地块,只在这 2048 个 token 上做精确 softmax 注意力。索引器用 KL 损失学习模仿全注意力的概率分布,梯度与主路径分离。
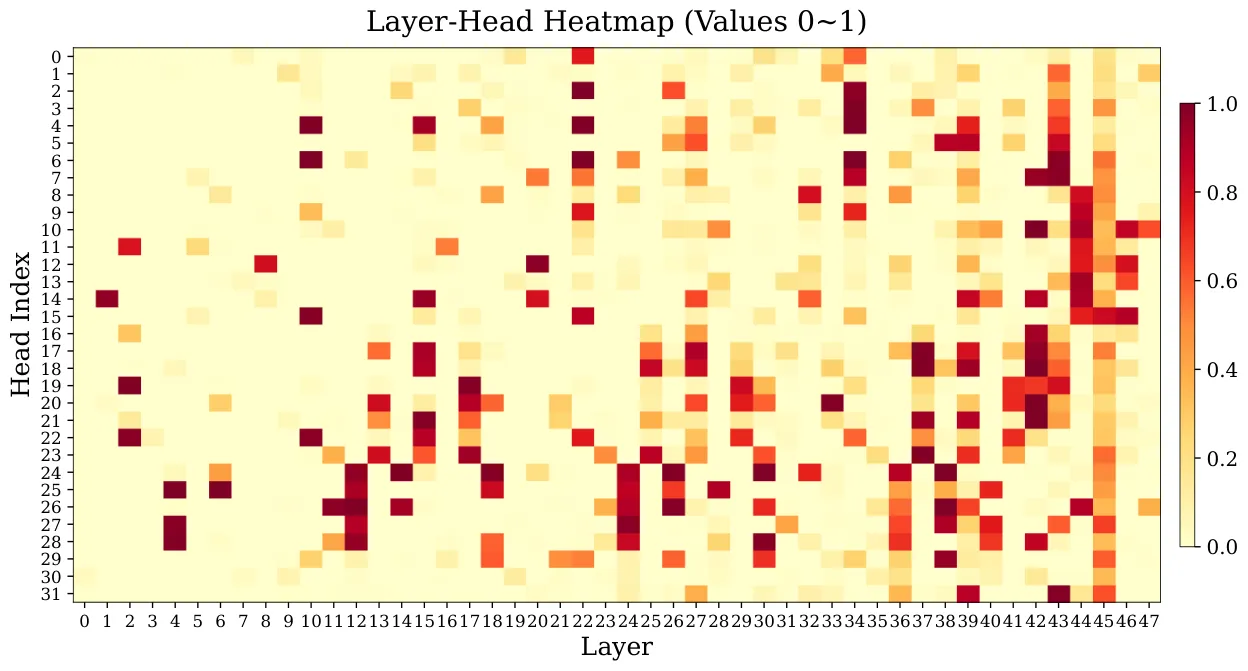
注意力头分工。 Full Attention Strikes Back(RTPurbo)从训练好的稠密模型出发,观察到只有少数头会回看很远的上下文。它保留约 15% 的头作为全上下文检索头,配一个 16 维索引器,其余 85% 改成 8192 token 滑动窗口加 4 个 sink token。两个各约 600 步的适配阶段完成转换。
带前瞻的 KV 卸载。 FlashMemory-DeepSeek-V4 改的不是注意力能看到哪些 token,而是哪些 token 常驻 GPU 显存。一个双编码器神经记忆索引器预测下一段会查询哪些 KV 块,只把它们留在 GPU 上,解码阶段 KV 缓存平均降到全上下文基线的 13.5%。
减少显存搬运的精确注意力。 FlashAttention 算出的数和全注意力完全一样。2 到 4 倍的提速来自分块计算,让 N×N 的注意力矩阵永远不落到 HBM。它才是”全注意力”的正确基线:一个稀疏方法如果只赢过朴素实现而没赢过 FlashAttention,就没有赢过任何生产系统真正在跑的东西。
关键数字
| 测量项 | 全注意力 | 稀疏变体 | 模型、设置、出处 | 同一套评测? |
|---|---|---|---|---|
| 1M 上下文下每 token 注意力 FLOPs | 1 倍 | 1/28.4 | 109B 多模态模型,MSA 论文 | 是 |
| 1M 上下文 H800 上预填充 / 解码耗时 | 1 倍 / 1 倍 | 快 14.2 倍 / 7.6 倍 | 同一模型,协同设计的 kernel,MSA | 是 |
| 每个查询组关注的 KV token 数 | 全部 | 2048(16 块 × 128) | MSA 设计 | 是 |
| HELMET-128K 总分 | 46.53 | 45.93 | MSA-CPT,140B 长上下文 token 之后 | 是 |
| RULER-128K 总分 | 72.00 | 72.12 | 同一次训练,MSA | 是 |
| 3T token 预算下 MMLU / GSM8K | 67.0 / 76.2 | 67.2 / 77.7 | MSA-PT,从头稀疏训练 | 是 |
| 预填充提速,1M / 32K | 1 倍 | 9.36 倍 / 2.83 倍 | Qwen3-Coder-30B-A3B,RTPurbo | 是 |
| 1M 下解码提速 | 1 倍 | 约 2.01 倍 | 同上,RTPurbo | 是 |
| LongBench 平均 | 53.80 | 54.24 | RTPurbo 对自己的稠密教师 | 是 |
| RULER 64K | 86.23 | 85.49 | RTPurbo | 是 |
| AIME24/25 准确率 | 86.67 | 86.67 | Qwen3-30B-A3B-Think,RTPurbo | 是 |
| 保留全上下文的头 | 100% | 15% | RTPurbo 设计 | 不适用 |
| 解码时常驻 GPU 的 KV 缓存 | 100% | 平均 13.5%,500K 时削减超 90% | FlashMemory-DeepSeek-V4,LongBench-v2 / LongMemEval / RULER | 是 |
| KV 卸载带来的精度变化 | 基线 | 平均 +0.6 分 | 同套基准,FlashMemory-DeepSeek-V4 | 是 |
| 精确注意力提速,GPT-2 1K 长度 | 朴素实现 1 倍 | 端到端 3 倍 | FlashAttention,输出完全相同 | 是,精确 |
每一行都是某篇论文内部,稀疏方法对它所派生或并行训练的稠密模型。不同论文之间的行不能互比:MSA 的 109B 模型、RTPurbo 的 Qwen3-Coder-30B-A3B、FlashMemory 的 DeepSeek-V4 骨干,在规模、训练数据和 kernel 上都不同。
FLOPs 不等于延迟
MSA 被引用最多的数字是 1M token 下注意力 FLOPs 少 28.4 倍,但在 H800 上实测变成预填充 14.2 倍、解码 7.6 倍。论文自己说了原因:稀疏注意力要额外做索引构建、top-k 选择、把选中的块聚集起来、反向索引,以及跨 GPU 的负载均衡,这些都不出现在 FLOP 计数里。RTPurbo 从另一端讲了同一个故事:1M token 下 9.36 倍的预填充收益到 32K 缩到 2.83 倍,因为稀疏化去掉的平方项在 32K 时本来就小,而索引器和检索头稠密预填充的固定开销并不小。FlashAttention 是参照点:它单靠减少显存搬运就让精确注意力提速 2 到 4 倍,所以在今天大多数部署跑的上下文长度上,一个好的稠密 kernel 和一个稀疏方法落在同一个区间。
实用规则:引用稀疏提速时必须带上上下文长度。1M token 上”快 10 倍”的说法,对一个 16K 的聊天负载几乎什么也说明不了。
质量丢在哪
每篇论文里总分变化都不到 1 分,有两处稀疏模型还小幅超过教师:RTPurbo 的 LongBench 54.24 对 53.80,MSA-PT 的 GSM8K 77.7 对 76.2。损失出现在固定检索预算会受伤的地方。MSA 的 HELMET 细分显示 Rerank 和 RAG 掉 2.10 分,多键多值检索反而升 2.24 分,这是真实的取舍而不是噪声。RTPurbo 在 RULER 64K 上让出 0.74 分,同时 AIME 完全持平。FlashMemory 报告平均 +0.6,但自己警告:索引器一旦漏掉恰好装着答案的那一块,失败会被平均数掩盖。
三篇论文共同的规律:需要一两次精确查找的任务在稀疏化后活得很好,有时因为忽略了干扰项反而更好;需要把散落在上下文各处的许多弱证据整合起来的任务,才是 2048 token 或 15% 头的预算可能无声丢东西的地方。
怎么选
- 上下文经常超过 128K,而且你掌控服务栈: 用稀疏注意力,把 kernel 当作交付物的一部分。能预训练或继续预训练就用 MSA 式块选择;必须保留现有稠密检查点又负担得起约 1200 步适配,就用 RTPurbo 式头转换。
- 瓶颈是 500K 下显存受限的解码,而不是算力受限的预填充: 带前瞻索引器的 KV 卸载打的正是这个瓶颈,保留全注意力语义,常驻缓存降约 7 倍。
- 上下文低于 32K: 全注意力配 FlashAttention 或其后继 kernel。稀疏收益不到 3 倍,而你保住了精确性、更简单的服务和不用训练的索引器。
- 推理密集型负载: AIME 持平让人放心,但只有一个模型家族。在自己的长链任务上前后各测一次,因为失效是无声的。
局限与存疑
三个稀疏结果都活在各自实验室的模型和 kernel 栈里:MSA 在 MiniMax 的 109B 模型,RTPurbo 在 Qwen3 变体,FlashMemory 在 DeepSeek-V4 骨干。向其他规模、GPU 和服务系统的可移植性是声明,不是测量。RTPurbo 的头分工假设头的角色在领域漂移下稳定。三篇论文都没有发布能暴露固定预算失效的对抗性证据整合测试。而你真正想要的对比,同一个稠密模型用三种方式转换、在同一套评测上跑,目前还不存在。
常见问题
在 32K 上下文下对比,稀疏注意力比全注意力快多少?
只快一点。RTPurbo 在 Qwen3-Coder-30B-A3B 上报告 32K 预填充提速 2.83 倍,而 1M 时是 9.36 倍;FlashAttention 单靠减少显存搬运就让精确注意力提速 2 到 4 倍。稀疏的优势要过了大约 128K token 才变大。
稀疏注意力相比全注意力在长上下文基准上掉多少精度?
长上下文综合基准上不到 1 分:MSA 在 HELMET-128K 上 45.93 对 46.53,RULER-128K 上 72.12 对 72.00;RTPurbo 在 RULER 64K 上 85.49 对 86.23,LongBench 上 54.24 对 53.80。损失集中在需要整合多处分散证据的任务,比如 MSA 在 Rerank 和 RAG 上掉的 2.10 分。
FlashAttention 和稀疏注意力的区别是什么?
FlashAttention 是精确的:输出和全注意力完全相同,快只是因为不把注意力矩阵写进 GPU 显存。稀疏注意力改变了计算本身,每个查询只关注一部分 key,在 1M token 上最多能省 28.4 倍 FLOPs,但输出可能改变。
有没有不重新训练就把全注意力模型转成稀疏注意力的方法?
能。RTPurbo 用两个各约 600 步的适配阶段转换 Qwen3-Coder-30B-A3B,保留 15% 的头看全上下文,其余改成 8192 token 滑动窗口,在 LongBench 和 AIME 上持平或略胜稠密模型。MSA-CPT 也是在稠密检查点上用稀疏注意力继续预训练。