
Kimi K3 论文解读:Delta 注意力、注意力残差与 896 个专家
Kimi K3 是 2.8T 参数、104B 激活的 MoE,由 3:1 的 KDA 与门控 MLA、注意力残差和 896 专家 LatentMoE 构成,缩放效率为 K2 的 2.5 倍。
快速答案
Kimi K3 是月之暗面 2026 年 7 月的旗舰:总参数 2.78T、每 token 激活 104.2B 的混合专家模型,93 层,通过从零训练的 MoonViT-V2 视觉塔实现原生视觉,训练上下文 1M token。相对 Kimi K2(总参数 1.04T,激活 32.6B,61 层,128K 上下文),架构在三处改变。token 混合变成 Kimi Delta Attention(KDA,一种带门控 delta 规则的线性注意力)与门控多头潜在注意力的逐层混合,三层 KDA 配一层全局注意力。深度混合加入注意力残差,每一层可以从所有前置层检索表示,而不是只读一条累积的残差。前馈侧变成 Stable LatentMoE,896 个路由专家、每 token 激活 16 个、外加 2 个共享专家,经由半宽的潜变量路由。报告把相对 K2 约 2.5 倍的整体缩放效率提升归于这些改动加上数据与配方的变化。权重开源,发布时 K3 是第一个登顶 WebDev Arena 的开源模型。
架构一览
3:1 的混合注意力。 每个块由三层 KDA 接一层门控 MLA 组成,骨干末尾再加一层门控 MLA,保证最后一层始终是全局注意力。KDA 在 delta 规则递推上加了逐通道遗忘门,让固定大小的状态能覆盖过时内容而不是一味累积。相对 Kimi Linear 有两处对硬件重要的改动:对数衰减用缩放 sigmoid 设下界,取代无界的负 softplus,使分块计算中的每个因果 tile 都能跑稠密的 Tensor Core 矩阵乘;输出门变成依赖输入的满秩投影。MLA 层保留 DeepSeek-V2 式的压缩 KV,让全局注意力在 1M token 下仍然负担得起。
注意力残差。 标准残差流把第 L 层之前的一切压成一个向量,报告把它比作沿深度的 RNN。AttnRes 让第 L 层以数据相关的权重关注所有前置层的输出。完整 AttnRes 代价高,K3 用块级变体:93 层按每 12 层分块,在块级摘要上做注意力,报告称这样找回了大部分收益。
Stable LatentMoE。 LatentMoE 通过 3584 维的潜变量把 token 路由到专家,是 7168 隐层宽度的一半,因此扩到 896 个专家、16 个激活时通信量不随路由数目线性增长。K3 在专家聚合与上投影之间加了 RMSNorm(Normalized LatentMoE),用有界的 SiTU-GLU 激活,并引入 Quantile Balancing,一种从分配问题的松弛推导出来的路由规则,在这种稀疏度下保持专家负载均衡。
逐头 Muon。 K3 用 Muon 训练矩阵参数,但对注意力投影是按头分别正交化各自的动量块,而不是整个 Q、K 或 V 矩阵,理由是整矩阵正交化把本该以不同尺度更新的头耦合在一起。同样的想法在 Pion 中被独立用于 RL 微调。
关键结果
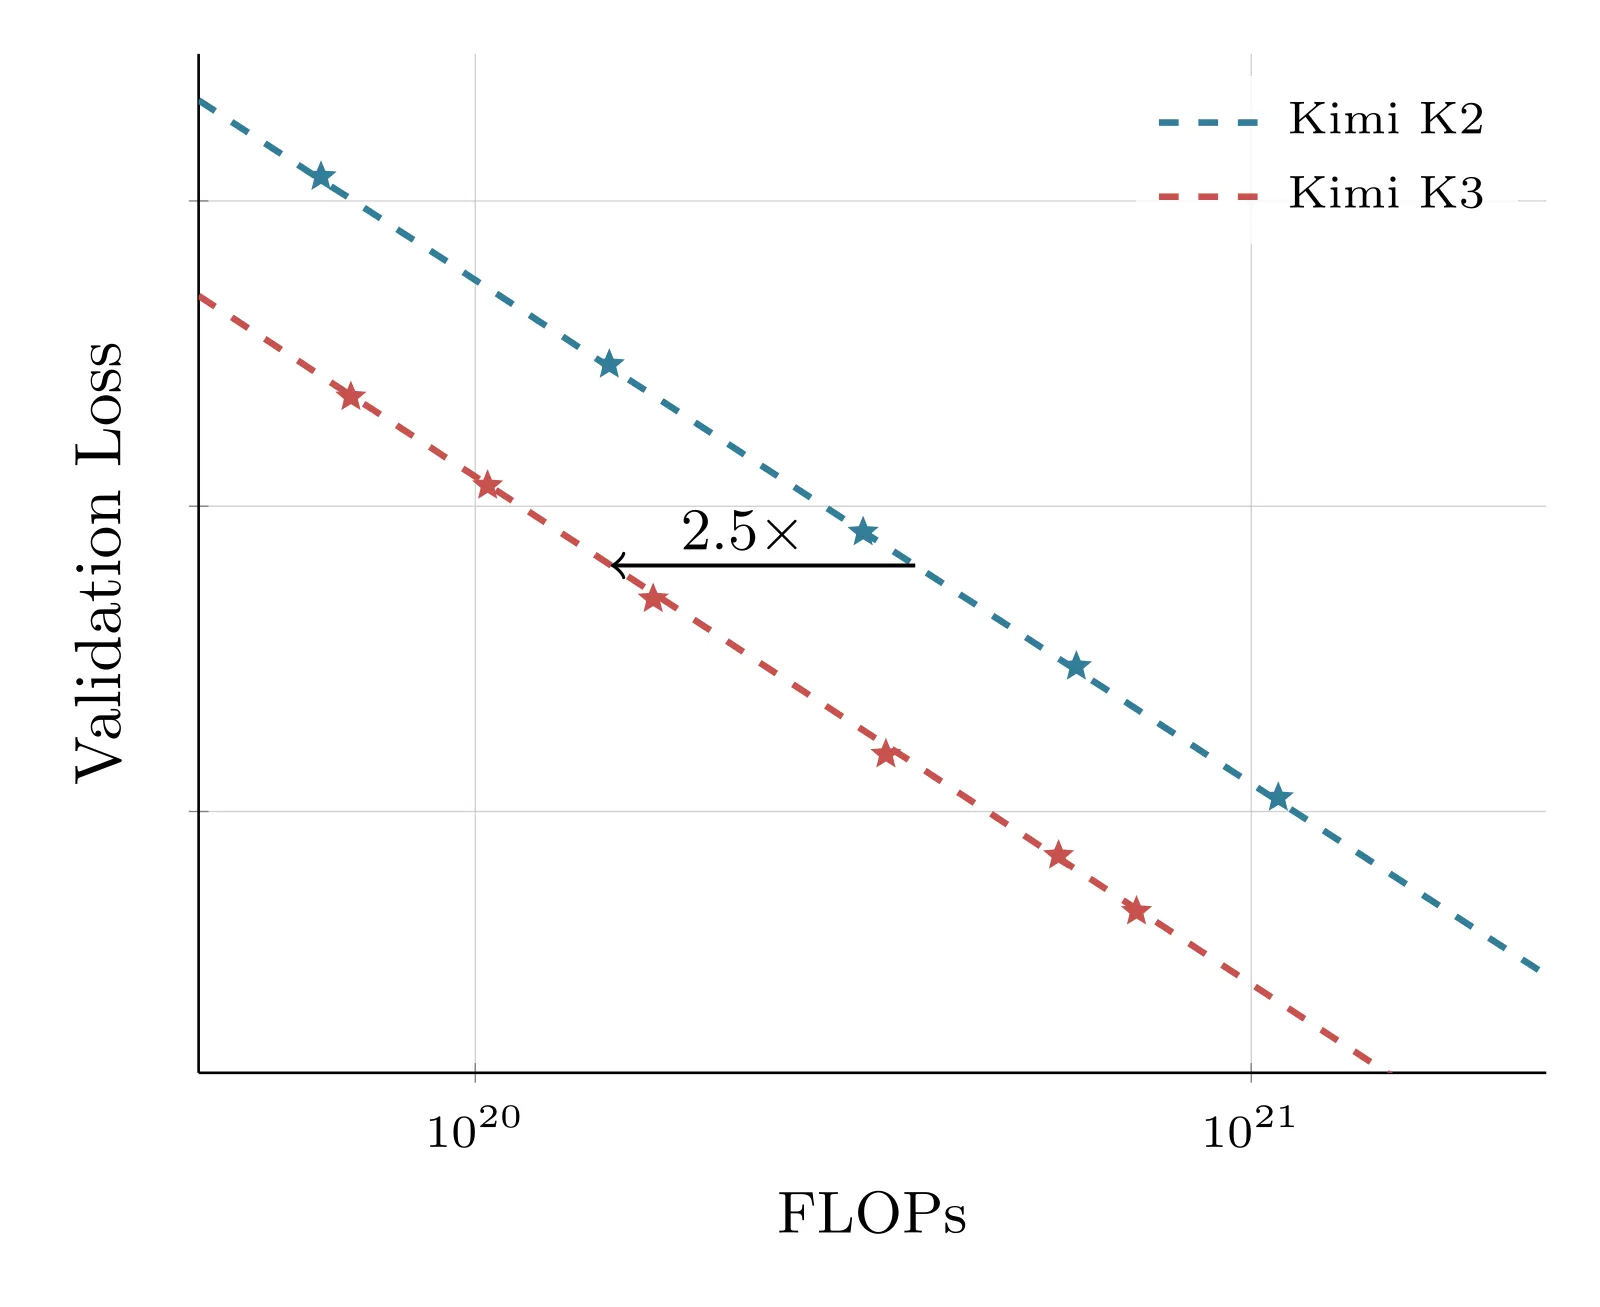
- 缩放效率: 图 7 的拟合缩放律显示 K3 达到给定损失所需算力约为 K2 的 1/2.5;报告把功劳共同归于 KDA、AttnRes、Stable LatentMoE 和数据配方,没有按组件拆分。
- 编码,全部最大推理强度(表 2): Terminal-Bench 2.1 88.3(GPT-5.6 Sol 88.8,Claude Fable 5 88.0,Opus 4.8 84.6),FrontierSWE 81.2(Fable 5 86.6,Sol 71.3),DeepSWE 67.5(Sol 73.0,Fable 5 70.0),ProgramBench 77.8(最佳),SWE-Marathon 42.0(最佳;Opus 4.8 40.0),SciCode 58.7(Fable 5 60.2)。
- 智能体: BrowseComp 91.2(最佳;Sol 90.4,Fable 5 88.0),MCPMark-Verified 94.5(最佳),AutomationBench 30.8(最佳),GDPval-AA v2 Elo 1686(Fable 5 1747,Sol 1736),AA-Briefcase 1548(Fable 5 1583),Agents’ Last Exam 28.3(Sol 29.6),JobBench 54.3(Fable 5 57.4)。
- 推理与知识: GPQA Diamond 93.5(Sol 94.1,Fable 5 92.6),HLE-Full 无工具 43.5、带工具 56.0(Fable 5 53.3 / 63.0),AA-LCR 74.7(最佳)。
- 第三方(截至 2026 年 7 月 23 日): Artificial Analysis 智能指数 v4.1 57.1,580 个模型中第 4;Vals 指数 74.7,39 个中第 2;WebDev Arena Elo 1678,99 个中第 1,首个登顶的开源模型;Text Arena 1486,200 个中第 8;Agent Arena 9.1,37 个中第 4。
- 训练规模: 2.8T 参数,带持久化 rollout 与沙箱状态的 1M token 智能体 RL,报告称完全负载均衡的 MoonEP 专家并行训练,以及面向部署的 MXFP4 量化感知后训练。
局限与存疑
2.5 倍是与月之暗面自家上一代模型的拟合缩放律比较,不是对每项架构改动的受控消融;报告没有把 KDA 的贡献与 AttnRes 或 MoE 改动分开。基准表用最大强度、温度 1 的 K3 对各家专有模型的最高设置,若干智能体数字依赖评测框架(Kimi Code Bench 上 K3 走 Kimi Code、其他模型走 Claude Code)。K3 在 FrontierSWE 上落后 Claude Fable 5 5.4 分,在 GDPval-AA 上落后 61 Elo,所以”前沿水平”对智能体和浏览套件是准确的,对最难的软件工程套件要打折。每个架构部件相对 DeepSeek-V4 和 Qwen3.8-Next 对同一问题的答案处在什么位置,见 Kimi K3 架构解读。
本文是 Muon 和 AdamW 的区别, Nemotron 3 架构解读, Qwen3.8-Next 架构解读 的来源论文之一。
常见问题
Kimi K3 的架构是什么?
93 层、2.78T 参数、104.2B 激活的 MoE。token 混合是三层 Kimi Delta Attention 交替一层门控 MLA;注意力残差让各层以 12 层为块读取所有前置层;Stable LatentMoE 通过 3584 维潜变量把每个 token 路由到 896 个专家中的 16 个外加 2 个共享专家;矩阵用逐头 Muon 训练。
Kimi K3 和 Kimi K2 相比如何?
K2 总参数 1.04T、激活 32.6B、61 层、384 个专家激活 8 个、只有 MLA 注意力、128K 训练上下文。K3 总参数 2.78T、激活 104.2B、93 层、896 个专家激活 16 个、KDA 与 MLA 混合、1M 上下文,报告缩放效率提升 2.5 倍。
Kimi K3 对 Claude 和 GPT 的基准结果如何?
最大强度下 K3 在 Terminal-Bench 2.1 得 88.3(GPT-5.6 Sol 88.8,Claude Fable 5 88.0),BrowseComp 91.2(表内最佳),GPQA Diamond 93.5,FrontierSWE 81.2(Fable 5 86.6)。发布时在 WebDev Arena 排第一,在 Artificial Analysis 智能指数排第四。
什么是 Kimi Delta Attention?
一种基于 delta 规则、带逐通道遗忘门的线性注意力层,用缩放 sigmoid 给对数衰减设下界,使分块计算能在稠密 Tensor Core tile 上运行,并配有依赖输入的满秩输出门。K3 每一层全局门控 MLA 对应三层 KDA。