
DeepSeek-V4 论文解读:压缩稀疏注意力与 10% KV 的百万上下文
DeepSeek-V4 发布 1.6T/49B 和 284B/13B 两个 MoE,用压缩稀疏与重度压缩注意力把 1M 上下文的 KV 缓存降到 V3.2 的 10%。
快速答案
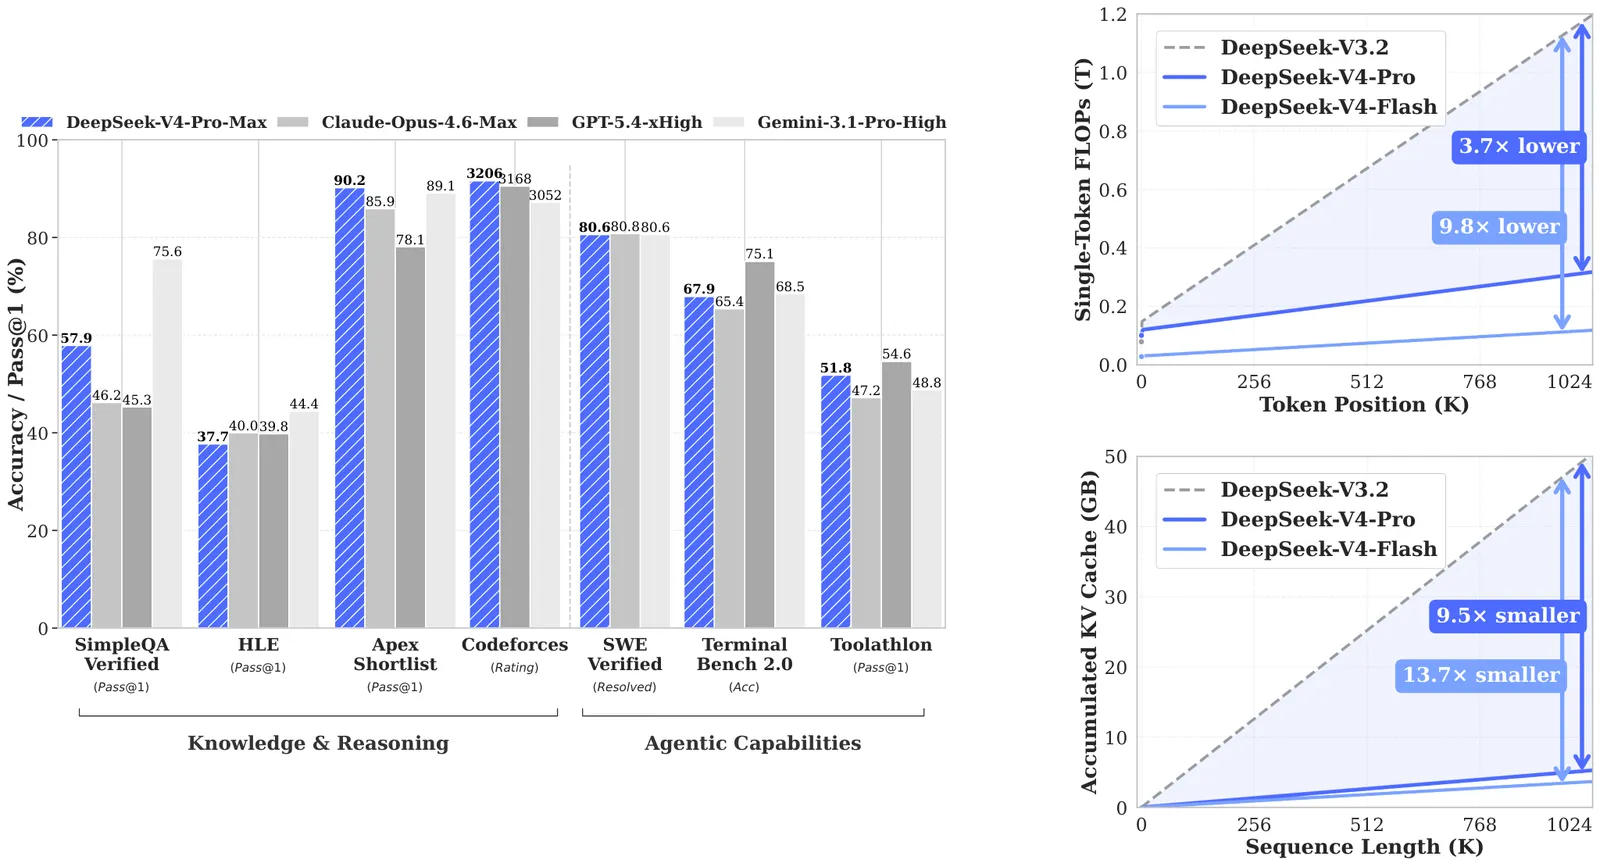
DeepSeek-V4 是 2026 年 4 月发布的预览系列,含两个混合专家模型:总参数 1.6T、激活 49B 的 DeepSeek-V4-Pro,以及总参数 284B、激活 13B 的 DeepSeek-V4-Flash。两者原生支持一百万 token 上下文。报告由三处改动撑起。一是压缩稀疏注意力(CSA)与重度压缩注意力(HCA)的混合注意力栈,在 1M token 下让 V4-Pro 的单 token 推理 FLOPs 降到 DeepSeek-V3.2 的 27%、KV 缓存降到 10%,V4-Flash 更是 10% 和 7%。二是流形约束超连接(mHC),一条加宽的残差流,其混合矩阵被投影到双随机矩阵上,使深层堆叠在数值上保持稳定。三是大多数模块采用 Muon 优化器,以求更快收敛和更稳的训练。预训练用了超过 32T token;最大推理强度模式 V4-Pro-Max 在报告自己的表格里于 LiveCodeBench、Codeforces 和 Apex Shortlist 上领跑开源模型,知识类任务落后于 Gemini-3.1-Pro。
注意力栈,以及为什么是两种机制
长上下文让注意力成为主要开销,V4 从两个方向进攻并把结果交错排布。CSA 先用学习到的压缩权重和位置偏置,把每 m 个连续 token 的 KV 缓存压成一个条目,再在压缩条目上运行 DeepSeek 稀疏注意力:一个 Lightning Indexer 以低秩方式给条目打分,每个查询只关注前 k 个压缩条目。一小段未压缩的近期 token 滑动窗口被加回来补足局部细节,一个注意力 sink 项允许每个头的得分之和小于 1。HCA 压缩得更狠,每个条目合并大得多的一组 token,同样保留滑动窗口和共享 KV 的多查询布局。各层在两者之间交替。KV 条目本身的旋转位置维度用 BF16、其余用 FP8 存储,路由专家权重用 FP4。
效率数字来自设计本身而不仅是 kernel:压缩把缓存按组大小缩小,稀疏把每个查询的计算缩到 top-k,HCA 层再把两者进一步缩小。图 1 画出了不同上下文长度下与 V3.2 的对比。
流形约束残差与大规模 Muon
超连接把残差流加宽若干倍,让各层通过学习到的输入、输出和残差混合映射读写。DeepSeek 发现朴素版本堆叠后数值不稳。mHC 用 Sinkhorn-Knopp 归一化把残差混合矩阵约束到双随机矩阵构成的 Birkhoff 多面体上,谱范数不超过 1,映射在前向和反向都是非扩张的;输入和输出映射用 sigmoid 限界。这个集合对乘法封闭,正是深层堆叠保持稳定的原因。
Muon 用于大多数权重矩阵,嵌入、预测头、mHC 的静态偏置与门、RMSNorm 权重仍用 AdamW。报告加入了混合 Newton-Schulz 日程和一个防止注意力 logit 爆炸的专门措施,3.4 节描述了分布式 Muon 实现。这是迄今公开的最大规模 Muon 预训练,V4 之后 Kimi K3 和 Qwen3.8-Next 也跟进采用。
关键结果
- 1M token 下的效率(图 1): V4-Pro 为 V3.2 单 token FLOPs 的 27%、KV 缓存的 10%;V4-Flash 为 10% 和 7%。V3.2 激活 37B 参数,V4-Flash 为 13B,V4-Pro 为 49B。
- 预训练: Flash 32T token,Pro 33T;沿用 V3 的 128K 词表并加入新的上下文构造 token;长文档策展侧重科学论文与技术报告。
- V4-Pro-Max 对闭源模型(表 6): LiveCodeBench 93.5(表内最佳;Gemini-3.1-Pro 91.7,Opus-4.6 88.8),Codeforces 评分 3206(最佳;GPT-5.4 3168),Apex Shortlist 90.2(最佳;Gemini 89.1),HMMT 2026 年 2 月 95.2(GPT-5.4 97.7),IMOAnswerBench 89.8(GPT-5.4 91.4),GPQA Diamond 90.1(Gemini 94.3),HLE 37.7(Gemini 44.4),MMLU-Pro 87.5(Gemini 91.0),SimpleQA-Verified 57.9(Gemini 75.6,Opus 46.2)。
- 智能体(表 6): SWE Verified 80.6(Opus-4.6 80.8,Gemini 80.6),SWE Pro 55.4(K2.6 58.6),Terminal Bench 2.0 67.9(GPT-5.4 75.1;Verified 子集约 72.0),BrowseComp 83.4(Gemini 85.9),带工具 HLE 48.2(K2.6 54.0),GDPval-AA Elo 1554(GPT-5.4 1674),MCPAtlas 73.6(Opus 73.8)。
- 长上下文: MRCR 1M 83.5,CorpusQA 1M 62.0,Opus-4.6 分别为 92.9 和 71.7。
- 推理强度很关键(表 7): V4-Pro 的 Non-Think、High、Max 在 GPQA Diamond 上分别为 72.9、89.1、90.1;HLE 7.7、34.5、37.7;SWE Verified 73.6、79.4、80.6。V4-Flash-Max 以 13B 激活参数达到 GPQA 88.1、SWE Verified 79.0、Terminal Bench 56.9、LiveCodeBench 91.6。
局限与存疑
报告自称预览版。表 6 中所有闭源模型都在 DeepSeek 自己的评测框架下运行,500 步交互、512K 上下文,作者说明 GPT-5.4 因 API 大量失败而没能在代码智能体任务上评测。与 Gemini-3.1-Pro 在 SimpleQA、HLE 和 MMLU-Pro 上的知识差距是真实且被承认的。1M 长上下文得分落后 Opus-4.6 九到十分,所以效率主张说的是 1M 下的每 token 成本,不是那里的回忆能力持平。压缩组大小和 top-k 记录在开源的推理代码里而非正文中完整给出。效率数字是 FP8 等效的 FLOP 估计和缓存大小,不是在指定服务栈上测得的延迟。
本文是 DeepSeek V4 架构解读, Kimi K3 架构解读, Muon 和 AdamW 的区别, Nemotron 3 架构解读, Qwen3.8-Next 架构解读 的来源论文之一。
常见问题
DeepSeek-V4 的架构是什么?
DeepSeekMoE 前馈栈配一套混合注意力:压缩稀疏注意力(把成组 token 压成单个 KV 条目,再经 Lightning Indexer 稀疏地关注 top-k)与重度压缩注意力(组更大)交错,两者都带一小段滑动窗口分支和注意力 sink。残差连接使用流形约束超连接,大多数矩阵用 Muon 训练。
DeepSeek-V4 在 1M 上下文下比 V3.2 高效多少?
一百万 token 上下文下,V4-Pro 只需 V3.2 单 token 推理 FLOPs 的 27% 和 KV 缓存的 10%;V4-Flash 为 10% 和 7%。这些是报告图 1 中 FP8 等效的估计值,不是实测延迟。
DeepSeek-V4-Pro-Max 与 Claude Opus 4.6、Gemini 3.1 Pro 相比如何?
在报告自己的表里,它在 LiveCodeBench(93.5)、Codeforces(3206)和 Apex Shortlist(90.2)上领先,SWE Verified 与 Opus 持平(80.6 对 80.8),知识类落后 Gemini:SimpleQA-Verified 57.9 对 75.6,HLE 37.7 对 44.4,GPQA Diamond 90.1 对 94.3。基线在 DeepSeek 的评测框架下运行。
DeepSeek-V4-Pro 和 V4-Flash 有什么区别?
Pro 总参数 1.6T、激活 49B;Flash 总参数 284B、激活 13B。Max 强度下 Flash 的 GPQA Diamond 88.1、SWE Verified 79.0、LiveCodeBench 91.6,Pro 为 90.1、80.6、93.5;1M 上下文下 Flash 用 V3.2 的 10% FLOPs,Pro 用 27%。