
强化学习 · 视觉-语言-动作 · 高效 AI · 大模型推理
Rethinking Muon 论文解读:Muon 在哪崩、Pion 怎么修
Muon 把更新的所有奇异值推向 1 的做法赢在预训练,却在可验证奖励强化学习里崩溃、在机器人策略上表现不佳;Pion 保留主导方向、压制噪声尾部,同时胜过 Muon 和 AdamW。
快速答案
Muon 用 Newton-Schulz 迭代把动量矩阵正交化,让所有奇异值趋向 1,这是一种均匀的谱白化。密歇根州立大学、思科研究院和明尼苏达大学 2026 年 5 月的这篇论文表明,白化虽然是 Muon 在预训练中胜过 AdamW 的原因,却在预训练之后的两个场景里成了错误的归纳偏置。在视觉-语言-动作(VLA)训练中,动作模块的梯度近似低秩,白化会放大尾部方向的噪声。在可验证奖励强化学习(RLVR)中,梯度信噪比很低,Muon 直接崩溃:在 Qwen3-1.7B 和 4B 上 GRPO 与 GMPO 的八个设置里,准确率始终接近零,常常低于起始检查点。论文提出的替代品 Pion 保持 Muon 的开销,用两阶段的提升加压制多项式取代白化,把主导奇异值锚定在 1、把尾部推向 0。用 VLA-Adapter 在 LIBERO 上,Pion 在 Object 套件训练 1500 步后达到 100% 成功率,Muon 是 97.0%,AdamW 只有 32.2%;在以 pi-0.5 为骨干的真实 Franka 机器人上,平均成功率从 AdamW 的 31.1% 和 Muon 的 38.9% 提升到 85.6%。
白化为什么在预训练之后失效
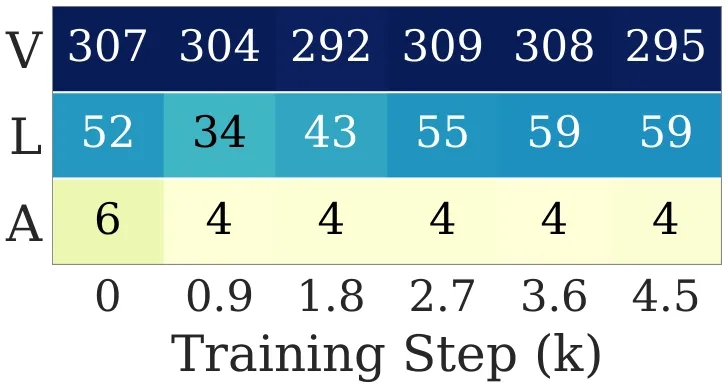
论文的诊断建立在两项测量上。第一,VLA 训练中各模块梯度的有效秩:视觉和语言模块的梯度保持高秩,动作头的梯度接近低秩。Newton-Schulz 对每个奇异方向一视同仁,低秩梯度里那些又小又噪的奇异值会被抬到和有信息的方向同样的量级。第二,同一模型和数据下 GRPO 与监督微调的梯度信噪比:GRPO 全程远低于 SFT,因为它的监督是轨迹级奖励而非逐 token 目标,重要性采样、裁剪和组归一化还会丢弃或重新加权部分梯度。在这种状态下,图 2 显示用 AdamW 的 GRPO 在 MATH500 上稳步提升,而用 Muon 的 GRPO 从初始检查点就开始崩溃。
第三项观察推动了逐头设计。预训练模型的注意力投影各头的权重范数并不一致,这些范数决定注意力的锐度和梯度的尺度。整矩阵正交化把所有头当成一个块处理,抹掉了这层结构。
Pion 改了什么
Pion 把 Newton-Schulz 多项式换成两个:一个提升步把大奇异值推向 1,一个压制步把小奇异值推向 0,并用一个可调阈值决定”大”从哪里开始。两者合起来是一个谱高通滤波器。每步开销与 Muon 相同,因为它仍然是对动量做几次矩阵多项式迭代。逐头模式把 Q、K、V 投影的动量按头重排,让每个头的块单独滤波,不增加开销。VLA 实验中 Pion 用于动作模块的矩阵,视觉和语言矩阵仍用 Muon;RLVR 中全程使用逐头模式。
两个消融钉住了机制。把滤波方向反过来做成低通 Muon(LPMuon),收缩大奇异值、放大小奇异值,它在 RLVR 上完全训不动,说明谱整形的方向才是有效成分。默认模式的 Pion 在 RLVR 上不如 AdamW,而逐头 Pion 获胜,逐头 Muon 依旧崩溃,说明只有先滤掉噪声,逐头结构才帮得上忙。
关键结果
- VLA-Adapter,LIBERO Object(图 5): Pion 500 步时成功率 95.4%,1500 步时 100%;同样 1500 步预算下 Muon 97.0%,AdamW 32.2%。Muon 在四个 LIBERO 套件上都胜过 AdamW,Pion 在四个套件上都胜过 Muon。
- VLANeXt,流匹配 VLA(表 1): LIBERO 平均 AdamW 79.45,Muon 93.65,Pion 96.35。LIBERO-Plus 平均 64.57、72.34、75.93。语言扰动下:54.50、77.53、86.93。机器人扰动下:47.04、57.36、63.18。
- 真机,DROID 设置下的 pi-0.5,20000 步,每任务 30 次试验(表 3): 平均成功率 AdamW 31.1%,Muon 38.9%,Pion 85.6%。黄瓜到盘子 40.0 / 56.7 / 93.3;方块到盘子 33.3 / 33.3 / 83.3;方块到碗 20.0 / 26.7 / 80.0。
- RLVR(图 6): 在 GRPO 与 GMPO、Qwen3-1.7B 与 4B、MATH 3 到 5 级与 GSM8K 的组合里,Muon 的验证准确率始终接近零;Pion 在每个设置里都比 AdamW 收敛更快,全程梯度信噪比更高(图 7)。
- 反向消融: 低通 Muon 在 GSM8K 上停留在初始检查点的准确率。
局限与存疑
VLA 证据是 LIBERO 仿真加一套真机设置,三个抓放任务、每个 30 次试验;RLVR 证据是两个小型 Qwen3 模型做数学。论文没有在预训练中测试 Pion,而白化正是预训练里的重点,也没有在前沿模型的大规模 RLVR 中测试。Pion 增加了一个滤波强度阈值,论文按模态分配优化器(动作用 Pion、视觉和语言用 Muon、其余用 AdamW)本身也是调出来的选择。附录 C 的信噪比理论解释了 Muon 在 GRPO 下的崩溃,但预测不了新任务需要多强的滤波。什么时候该选哪个优化器的全貌见 Muon 和 AdamW 的区别。
常见问题
Muon 为什么会在可验证奖励强化学习里崩溃?
GRPO 和 GMPO 的梯度信噪比很低,因为奖励是轨迹级的,裁剪、重要性采样和组归一化又丢掉了部分信号。Muon 的 Newton-Schulz 步骤把每个奇异方向抬到同样的量级,噪声方向和有信息的方向权重相同,策略于是崩溃;论文里八个设置的准确率都接近零。
Pion 和 Muon 有什么区别?
Pion 用高通滤波取代均匀白化:提升多项式把主导奇异值锚定在 1,压制多项式把小奇异值推向 0,阈值可调。它还支持注意力投影的逐头模式。每步开销与 Muon 相同。
Pion、Muon、AdamW 在 LIBERO 和真机上的结果是什么?
用 VLANeXt,LIBERO 平均成功率 Pion 96.35、Muon 93.65、AdamW 79.45。在以 pi-0.5 为骨干的真实 Franka 机器人上,训练 20000 步后三个抓放任务的平均成功率 Pion 85.6%,Muon 38.9%,AdamW 31.1%。
逐头 Muon 能修好 RLVR 的问题吗?
不能。逐头 Muon 依旧崩溃,默认模式的 Pion 也不如 AdamW,只有逐头 Pion 获胜。论文的解读是:滤除噪声是首要条件,逐头结构在滤波到位后才有帮助。