
Qwen3.8-Next 架构论文解读:GDN 混合、QSA 与门控残差
Qwen3.8-Flash-Next 是 125B 参数、6B 激活的 MoE;GDN 混合、稀疏注意力、门控残差和 Muon 让它以 1/9 FLOPs 追平 Qwen3.7-Plus。
快速答案
Qwen 团队 2026 年 8 月的这篇论文是一份架构消融报告,而不是模型卡。它的对象 Qwen3.8-Flash-Next 有 125B 总参数、每 token 激活 6B,另有 51B 参数的 n-gram 嵌入表放在主机内存里按需预取,不占加速器显存。在 14 项预训练基准上,基座模型在 8 项上领先 397B-A17B 的前代 Qwen3.7-Plus,其余 6 项落后不超过 2.6 分,而激活参数约为三分之一、训练 token 约为三分之一、训练 FLOPs 约为九分之一。四个组件撑起设计:Gated DeltaNet(GDN)与全局注意力的逐层混合,每四层一层全注意力;在继续预训练时替换掉这些全注意力层的 Qwen 稀疏注意力(QSA);把残差流加宽到四条分支、经逐元素门读取的门控残差;以及单层 n-gram 嵌入。每个候选改动都同时按三条轴评判:损失与下游精度、训练与预填充和解码的成本、对最优超参数和稳定性的影响。
架构一览
token 混合。 GDN 层以线性代价把前缀压进固定大小的状态;每四层中的那层注意力保留精确的 token 级检索,论文指出这是任何有限状态记忆都无法精确复现的。支撑这一分配的消融在相同的 4800 亿 token 上训练三个 28 层 25B-A3B 检查点:全注意力 Transformer、窗口 128 的滑动窗口混合、GDN 混合。九项基准平均分别是 49.87、51.15、53.81。GDN 混合在 MATH(53.98 对 49.40)、BBH(68.72 对 63.78)和 MultiPL-E(47.48 对 39.73)上领先。
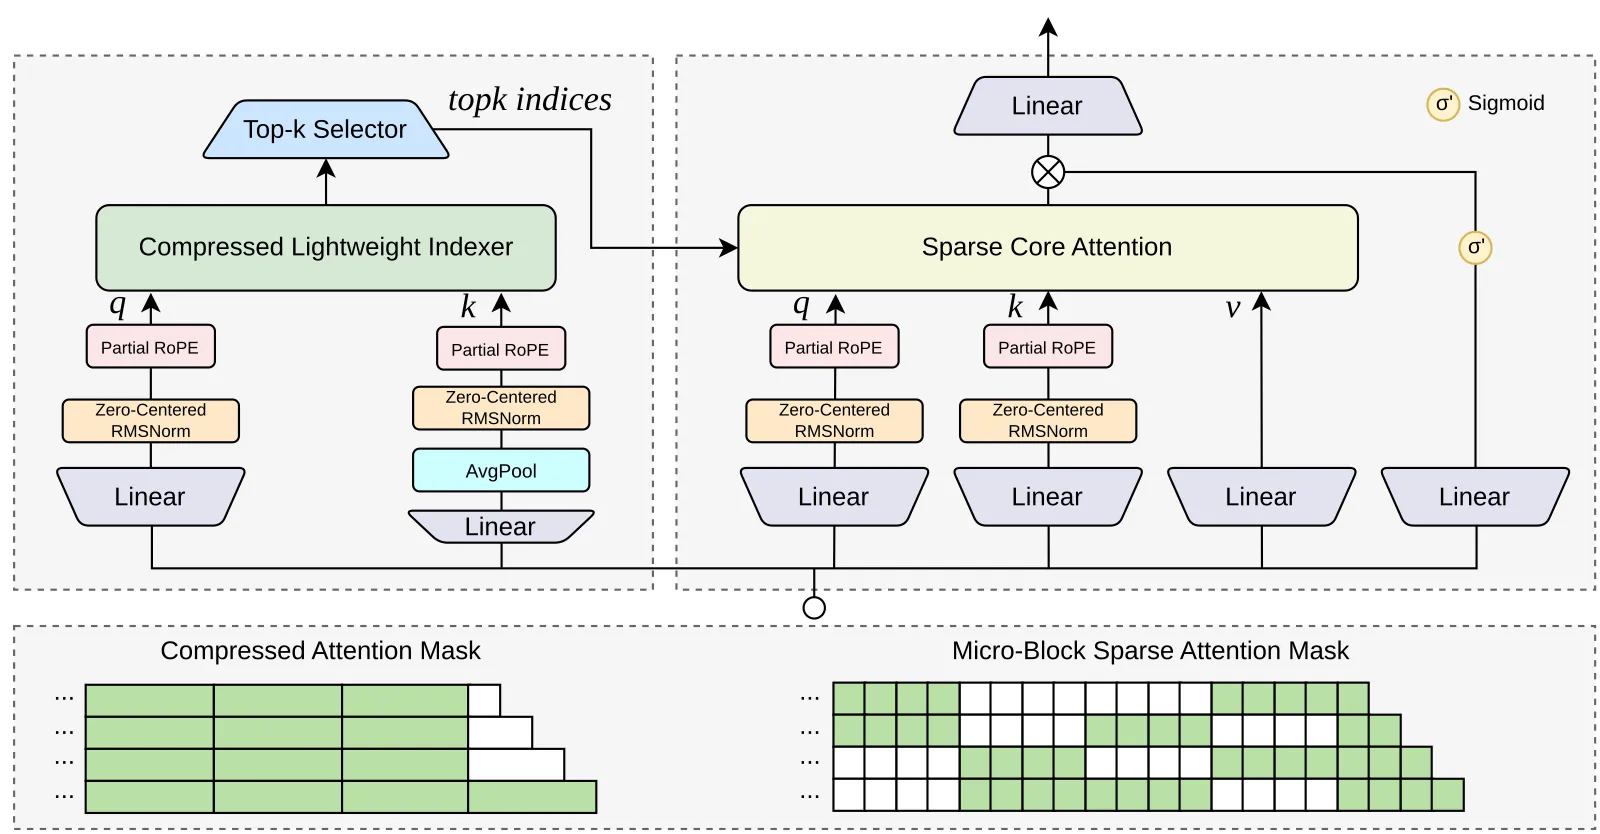
Qwen 稀疏注意力。 继续预训练时全注意力层变为 QSA。一个轻量索引器把序列压缩成微块表示,在压缩的因果掩码下打分并选出前 k 个块,再展开成微块级稀疏掩码供核心注意力使用。微块粒度的意义在于索引成本本身随序列长度下降,论文以此对比那些索引器开销在长上下文下仍不可忽略的稀疏设计。kernel 以 FlashQLA 开源。
门控残差。 残差流加宽到四条分支。它不用超连接设计里静态或动态的混合矩阵,而是让每个子层通过带分组 RMSNorm 的逐元素门读取各分支再写回;论文的消融发现读写足够有表达力后混合算子贡献很小,而门提供的重缩放才是保持训练稳定的东西。读和写各融合成单个 kernel,加宽的流每个块每个方向只遍历一次。
n-gram 嵌入。 单层 n-gram 嵌入表以局部上下文而非单个 token 身份为条件,增加 51B 参数而每 token FLOPs 几乎不变,因为表从主机内存预取。扩大 n-gram 词表能单调降低损失,但下游精度饱和,这是论文里损失与精度不一致的例子之一。
优化器与稳定性。 Muon 是主优化器,用于真正充当线性映射的二维权重:注意力和 GDN 的投影、专家 MLP、n-gram 的 key 和 value 投影。嵌入、输出头和 MoE 路由器留在 AdamW 上,路由器是因为 Muon 在训练早期让它不稳定。在 25B-A3B 模型上用恒定学习率做压力测试,比较 AdamW 下的 Qwen3.5 结构、同结构换 Muon、以及 Muon 加门控残差:门同时降低了梯度范数尖峰的频率和幅度,另一组消融在固定优化器的条件下单独隔离了 GatedNorm 的作用。
关键结果
- 基座模型对前代(表 11): Qwen3.8-Flash-Next-Base 对 Qwen3.7-Plus-Base,MMLU 90.36 对 90.43,MMLU-Pro 73.23 对 70.90,SuperGPQA 51.36 对 48.42,BBH 90.87 对 89.41,GPQA 51.42 对 51.52,GSM8K 93.29 对 92.95,MATH 72.78 对 74.38,EvalPlus 78.76 对 78.06,MultiPL-E 79.09 对 81.68,SWEBench-Pretrain 50.99 对 49.24,MGSM 89.33 对 85.42,MMMLU 84.86 对 84.53,INCLUDE 78.40 对 78.90。稠密的 Qwen3.8-27B-Base 在多数行上落后于两者。
- 混合消融(表 1): 25B-A3B 上九项基准平均,全注意力 49.87,SWA 混合 51.15,GDN 混合 53.81。
- 生产模型上 QSA 对全注意力(表 2): 短上下文平均全注意力 75.9,QSA 76.8;MMLU-Pro 72.9 对 73.7,MATH 69.8 对 71.6,EvalPlus 70.8 对 72.3。
- 长上下文(表 3): RULER 512K 到 1M 全注意力 90.08,QSA 93.00;8 针 MRCR 512K 30.66 对 40.53,1M 20.71 对 26.44;RULER 128K 基本持平在 99.8。
- 推测解码不受影响(表 4): 四步起草下 MTP 平均接受长度全注意力 4.06,QSA 4.07。
- 效率主张: 上述结果以约 1/3 的激活参数、1/3 的训练 token、约 1/9 的训练 FLOPs 取得。
局限与存疑
头条对比是基座对基座、在预训练基准上;本文没有后训练或智能体结果。1/9 FLOPs 由参数与 token 的比例推出,而非两次训练各自报告的总算力。混合消融在 25B-A3B、4800 亿 token 上,残差消融在 5600 亿 token 上,组件结论都在生产规模之下得出。把 51B 参数的 n-gram 表放到主机内存并预取,论文称延迟开销可忽略,但这取决于服务系统的主机带宽。这套设计与 DeepSeek-V4 的压缩注意力、Kimi K3 的 delta 注意力如何对比,见 Qwen3.8-Next 架构解读。
本文是 Kimi K3 架构解读, Muon 和 AdamW 的区别 的来源论文之一。
常见问题
Qwen3.8-Next 的架构是什么?
125B 参数、每 token 激活 6B 的稀疏 MoE,另有 51B 主机内存中的 n-gram 嵌入表。token 混合是三层 Gated DeltaNet 交替一层注意力,继续预训练时用 Qwen 稀疏注意力替换注意力层。残差流有四条分支,经逐元素门读取,大多数矩阵用 Muon 训练。
Qwen3.8-Flash-Next 与 Qwen3.7-Plus 相比如何?
基座模型在 14 项预训练基准中的 8 项领先 397B-A17B 的 Qwen3.7-Plus,其余落后不超过 2.6 分,例如 MMLU-Pro 73.23 对 70.90、MultiPL-E 79.09 对 81.68,而激活参数和 token 约为三分之一、训练 FLOPs 约为九分之一。
Qwen 稀疏注意力相比全注意力会掉精度吗?
在报告的设置里不会。短上下文平均从 75.9 升到 76.8,RULER 512K 到 1M 从 90.08 升到 93.00,8 针 MRCR 1M 从 20.71 升到 26.44,MTP 接受长度保持在约 4.07。
Qwen3.8-Next 为什么用 Gated DeltaNet 而不是滑动窗口注意力?
在 25B-A3B、相同 token 的受控消融里,GDN 混合平均 53.81,滑动窗口混合 51.15,全注意力 49.87,最大的增益在 MATH、BBH 和 MultiPL-E 上,同时每四层保留一层全注意力做精确检索。