
Nemotron 3 Ultra 解读:NVFP4 训出的 Mamba 混合 MoE
英伟达 550B 总参数、55B 激活的 Mamba 注意力混合 MoE,NVFP4 下 20T token 预训练;以少几分精度换最高 5.9 倍解码吞吐。
快速答案
Nemotron 3 Ultra 是英伟达 2026 年 6 月的旗舰开源模型:550B 总参数、每 token 激活 55B、108 层,Mamba-2 状态空间层与注意力的混合,用 LatentMoE 专家做稀疏扩展,并内置两个共享权重的多 token 预测头。它以 NVFP4 精度在 20 万亿 token 上预训练,上下文扩展到 1M token,后训练包括监督微调、多环境可验证奖励 RL,以及两轮多教师在线策略蒸馏(MOPD)。卖点是持平精度下的吞吐:在 8K 输入、64K 输出的解码密集设置下,报告的推理吞吐分别是 GLM-5.1-754B-A40B 的 5.9 倍、Kimi-K2.6-1T-A32B 的 4.8 倍、Qwen-3.5-397B-17B 的 1.6 倍,而智能体与推理分数与这些模型相差几分,在若干项上落后于 DeepSeek-V4-Pro。基座、后训练和 NVFP4 检查点、训练数据与配方全部开源。
架构一览
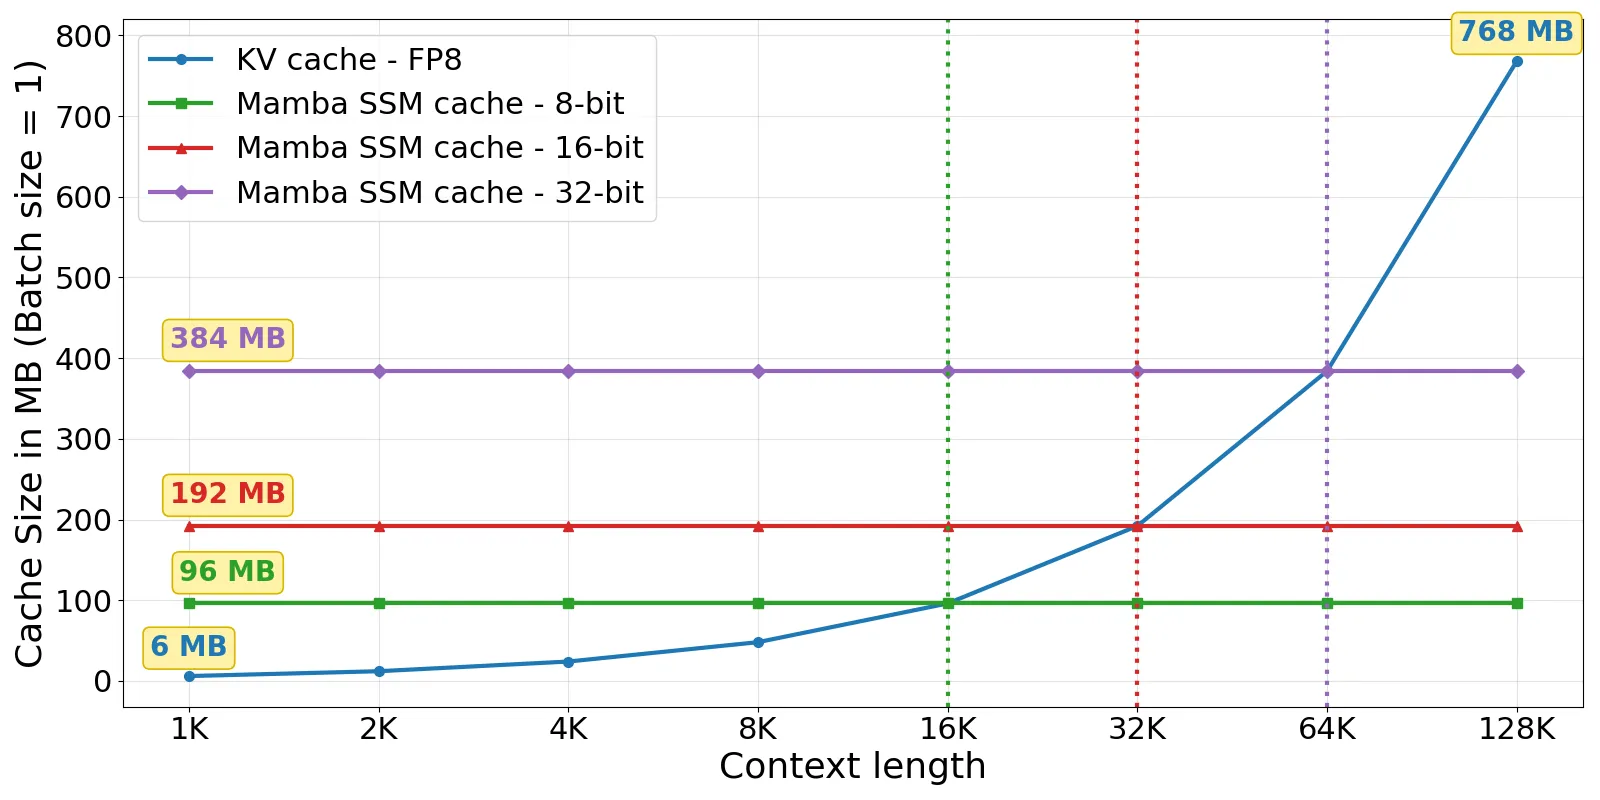
层模式沿袭 Nemotron 3 Super:大多数 token 混合层是 Mamba-2 状态空间层,其每步解码代价与序列长度无关,间插少量注意力层,前馈侧是 LatentMoE。表 1 的维度解释了吞吐:隐层 8192;64 个查询头但只有 2 个 key-value 头,头维 128,所以注意力层的 KV 缓存很小;256 个维度 64 的 Mamba 头,状态维 128,分 8 组;每层 512 个专家,激活前 22 个,MoE 潜变量 2048 维;专家隐层 5120,外加中间尺寸 10240 的共享专家。LatentMoE 通过潜变量把 token 路由到专家,英伟达报告它比标准细粒度 MoE 有更好的每参数精度。量化一节的图 14 直接展示了回报:同样批大小和长度下,Mamba 的 SSM 缓存远小于 FP8 的 KV 缓存。
多 token 预测是内置的:两个 MTP 头共享参数,各由一层注意力接一层 MoE 组成,既用于推理时的推测解码,也用于后训练时加速 RL 采样,每步 3 个草稿 token 相比不用 MTP 缩短了采样时间。
NVFP4 预训练,以及出了什么问题
预训练全程 NVFP4,采用 warmup-stable-decay 日程,15T token 偏重多样性,随后 5T 偏重质量。从 5T、10T、16T 检查点切换到 BF16 的消融显示,再训 740 亿 token 后训练损失差距分别为 0.33%、0.34% 和 0.03%,这是低精度训练能跟住 BF16 训练的证据。报告对不稳定性很坦诚:训练在第一阶段数据上发散了两次,回滚到 15T 检查点并改用 FP32 reduce-scatter 后再次发散,回滚后立即开始学习率退火才缓解,团队最终把计划的 token 总量削减到 20T。他们没能找出单一原因,但记录了不均衡与死亡专家、残差流范数不均衡这两个候选。
关键结果
- 基座模型(表 2): Nemotron-3-Ultra-Base 对 DeepSeek-V3.2-Exp-Base、Mistral-Large-3-675B-Base、Kimi-K2-Base 和 GLM-4.5-Base:MMLU 89.08(次佳 87.82),MMLU-Pro 79.07(69.15),AGIEval-En 78.73(72.55),GPQA 50.00(43.43),MATH 82.00(68.40),HumanEval 83.84(78.20),MBPP-Sanitized 85.97(84.08);GSM8K 88.10 落后于 Mistral 的 91.21 和 Kimi 的 91.05。
- MOPD 带来的后训练提升(表 5): Terminal Bench 2.0 从 SFT 34.5 → RLVR 44.5 → MOPD1 50.8 → MOPD2 54.0,超过自己 50.0 的教师;SWE-Bench Verified 63.5 → 65.8 → 70.1 → 71.7(教师 72.5);TauBench Telecom 55.7 → 82.7 → 91.2 → 92.9(教师 94.0);BrowseComp 14.3 → 31.0 → 41.0 → 44.4(教师 51.0);GDPVal 23.2 → 28.9 → 46.7(教师 49.5)。
- 后训练模型对开源模型(表 10): Terminal Bench 2.1 56.4(GLM-5.1 59.3,Kimi-K2.6 67.2,DeepSeek-V4-Pro 49.2),SWE-Bench Verified 70.7(GLM-5.1 76.2,Kimi-K2.6 75.7,DS-V4-Pro 74.5),GDPVal 46.7(GLM-5.1 54.7),BrowseComp 44.4(Kimi-K2.6 61.3),LiveCodeBench v6 89.0(DS-V4-Pro 92.5),GPQA 87.0(Kimi-K2.6 91.0),无工具 HLE 26.7(DS-V4-Pro 37.7),MMLU-Pro 86.8(Qwen-3.5 88.3),RULER 1M 94.7(最佳),IOI 2025 570.0(Kimi-K2.6 585.0),IFBench 81.7(DS-V4-Flash 82.0),OmniScience 非幻觉率 78.7(大幅领先)。
- 吞吐(图 1、图 15): NVFP4 最大吞吐下,8K 输入 / 64K 输出为 GLM-5.1 的 5.9 倍、Kimi-K2.6 的 4.8 倍、Qwen-3.5 的 1.6 倍;在 50K 输入 / 2K 输出的预填充密集设置下落后 Qwen-3.5,与”激活参数决定预填充、总权重 I/O 决定解码”的分析一致。
- 量化: 单个 NVFP4 检查点同时服务 W4A16 和原生 W4A4;在 4.85 到 7.19 比特每元素的扫描里,只有长上下文推理(AA-LCR)有变化,加入混合 FP8 层后从 62.25 升到约 64.7。
局限与存疑
吞吐数字是英伟达在自家硬件上按最大吞吐测的,可用时开启推测解码,并为每个模型取最好的数字。精度上,Ultra 在头条编码和搜索套件上落后最强开源模型 5 到 17 分(SWE-Bench Verified 70.7 对 76.2,BrowseComp 44.4 对 61.3,HLE 26.7 对 37.7),主要在长上下文、指令遵循和非幻觉上领先。预训练的不稳定迫使训练比计划更短,报告也没有声称找到原因。MOPD 最大的收益在学生预热起作用的智能体任务上,而通用推理教师自己在 HLE 上也落后 DeepSeek-V4-Pro。这套以 Mamba 为主的设计相对 Kimi 的 delta 注意力和 DeepSeek 的压缩注意力处于什么位置,见 Nemotron 3 架构解读。
常见问题
Nemotron 3 Ultra 的架构是什么?
108 层的 Mamba-2 状态空间层与注意力层混合,注意力有 64 个查询头和 2 个 key-value 头,用 LatentMoE 前馈层稀疏扩展,每层 512 个专家、每 token 通过 2048 维潜变量激活 22 个,总参数 550B、激活 55B,另有两个共享权重的多 token 预测头。
Nemotron 3 Ultra 比其他开源模型快多少?
英伟达报告在 8K 输入、64K 输出的负载上,NVFP4 最大吞吐下解码吞吐分别是 GLM-5.1-754B-A40B 的 5.9 倍、Kimi-K2.6-1T-A32B 的 4.8 倍、Qwen-3.5-397B-17B 的 1.6 倍。在 50K 输入的预填充密集负载上它落后于 Qwen-3.5。
Nemotron 3 Ultra 在基准上与 DeepSeek-V4 和 Kimi K2.6 相比如何?
它在 RULER 1M(94.7)和非幻觉率上领先,但在最难的智能体和知识套件上落后:SWE-Bench Verified 70.7 对 74.5(DS-V4-Pro)和 75.7(Kimi-K2.6),Terminal Bench 2.1 56.4 对 67.2(Kimi-K2.6),HLE 26.7 对 37.7(DS-V4-Pro),BrowseComp 44.4 对 61.3(Kimi-K2.6)。
Nemotron 3 的多教师在线策略蒸馏是什么?
SFT 和 RL 之后的一个后训练阶段,用多个专门教师对学生自己的输出打分,进行两轮。它把 Terminal Bench 2.0 从 44.5 提到 54.0,超过 50.0 的教师;把 SWE-Bench Verified 从 65.8 提到 71.7,教师为 72.5。