
Muon is Scalable 论文解读:比 AdamW 省一半算力
Moonshot 证明 Muon 加权重衰减和更新量缩放后,能以约一半算力达到 AdamW 的损失;5.7T token 训出的 16B MoE 模型 Moonlight 是证据。
快速答案
Muon 用一个按矩阵进行的步骤替代 AdamW 逐元素的归一化:取每个权重矩阵的动量,用几步 Newton-Schulz 迭代把它正交化,让所有奇异值趋向 1,再把结果当作更新。Keller Jordan 2024 年的版本在小模型上有效。Moonshot AI 这篇 2025 年 2 月的论文说明了把它用到大模型规模需要什么:加上 AdamW 式的权重衰减,并把每次更新缩放到均方根约等于 AdamW 常见的 0.2 到 0.4,这样 Muon 可以直接复用为 AdamW 调好的学习率和权重衰减。做完这两处修改,缩放律拟合显示 Muon 用大约一半的训练 FLOPs 达到与 AdamW 相同的损失;作者同时发布了 Moonlight,一个激活 3B、总参数 16B、用 Muon 在 5.7T token 上训练的混合专家模型。
让它可扩展的两处修改
第一个问题表现为增长。没有权重衰减时,Muon 训练的权重和层输出的 RMS 持续增大,直到超出 bf16 能精确表示的范围。原版 Muon 完全省略了权重衰减;论文加入 AdamW 的解耦衰减,并在图 2 中展示:在 800M 参数、100B token 的训练里,不带衰减的 Muon 起步更快但后期被反超,带衰减的 Muon 全程领先 AdamW。
第二个问题是正交化后的更新量,其 RMS 取决于矩阵形状,大致是较大维度的平方根分之一。这使得有效步长在各层之间不一致,也和 AdamW 不同,两种优化器无法共享超参数。修法是把每个更新乘以 0.2 倍较大矩阵维度的平方根,把更新 RMS 固定在约 0.2。论文在 800M 模型上测试了这个思路的三个变体,归一化更新和调整学习率两种做法都达到 2.789 的验证损失,未调整的基线是 2.812。实际后果就是大家现在用的那条:Muon 可以原样接过 AdamW 的学习率和权重衰减。
所有不是二维权重矩阵的参数,即嵌入、输出头和逐通道参数,仍然交给 AdamW。Muon 还需要一个分布式实现,按 ZeRO-1 方式切分动量,只在 Newton-Schulz 步骤时聚合完整矩阵;论文开源了这份代码。
关键结果
- 缩放律: 从 399M 到 1.5B 五个模型规模、按算力最优 token 数训练,图 3 的拟合曲线显示 Muon 达到相同损失只需约一半 FLOPs。论文表述为约 2 倍的计算效率。
- 1.2T token 处的受控优化器对换(表 4): Moonlight(Muon)对 Moonlight-A(架构、数据、日程完全相同,AdamW)。MMLU 60.4 对 60.2,HumanEval 37.2 对 29.3,MBPP 52.9 对 49.2,GSM8K 45.0 对 43.8,MATH 19.8 对 16.1。BBH 反过来,43.2 对 45.3。两者都胜过用 AdamW 在 1.33T token 上训练的同类 MoE 模型 DeepSeek-V3-Small。
- 5.7T token 的最终 Moonlight(表 5): MMLU 70.0,MMLU-Pro 42.4,HumanEval 48.1,MBPP 63.8,GSM8K 77.4,MATH 45.3,激活参数 2.24B。用 18T token 训练的 Qwen2.5-3B 是 MMLU 65.6、GSM8K 79.1;用 9T token 训练的 Llama3.2-3B 是 54.7 和 34.0。
- 收益集中在哪: 作者指出 Muon 的优势在数学和代码上最大,表 4 印证了这一点:HumanEval 和 MATH 分别变化 8 分和 3.7 分,MMLU 只变 0.2。
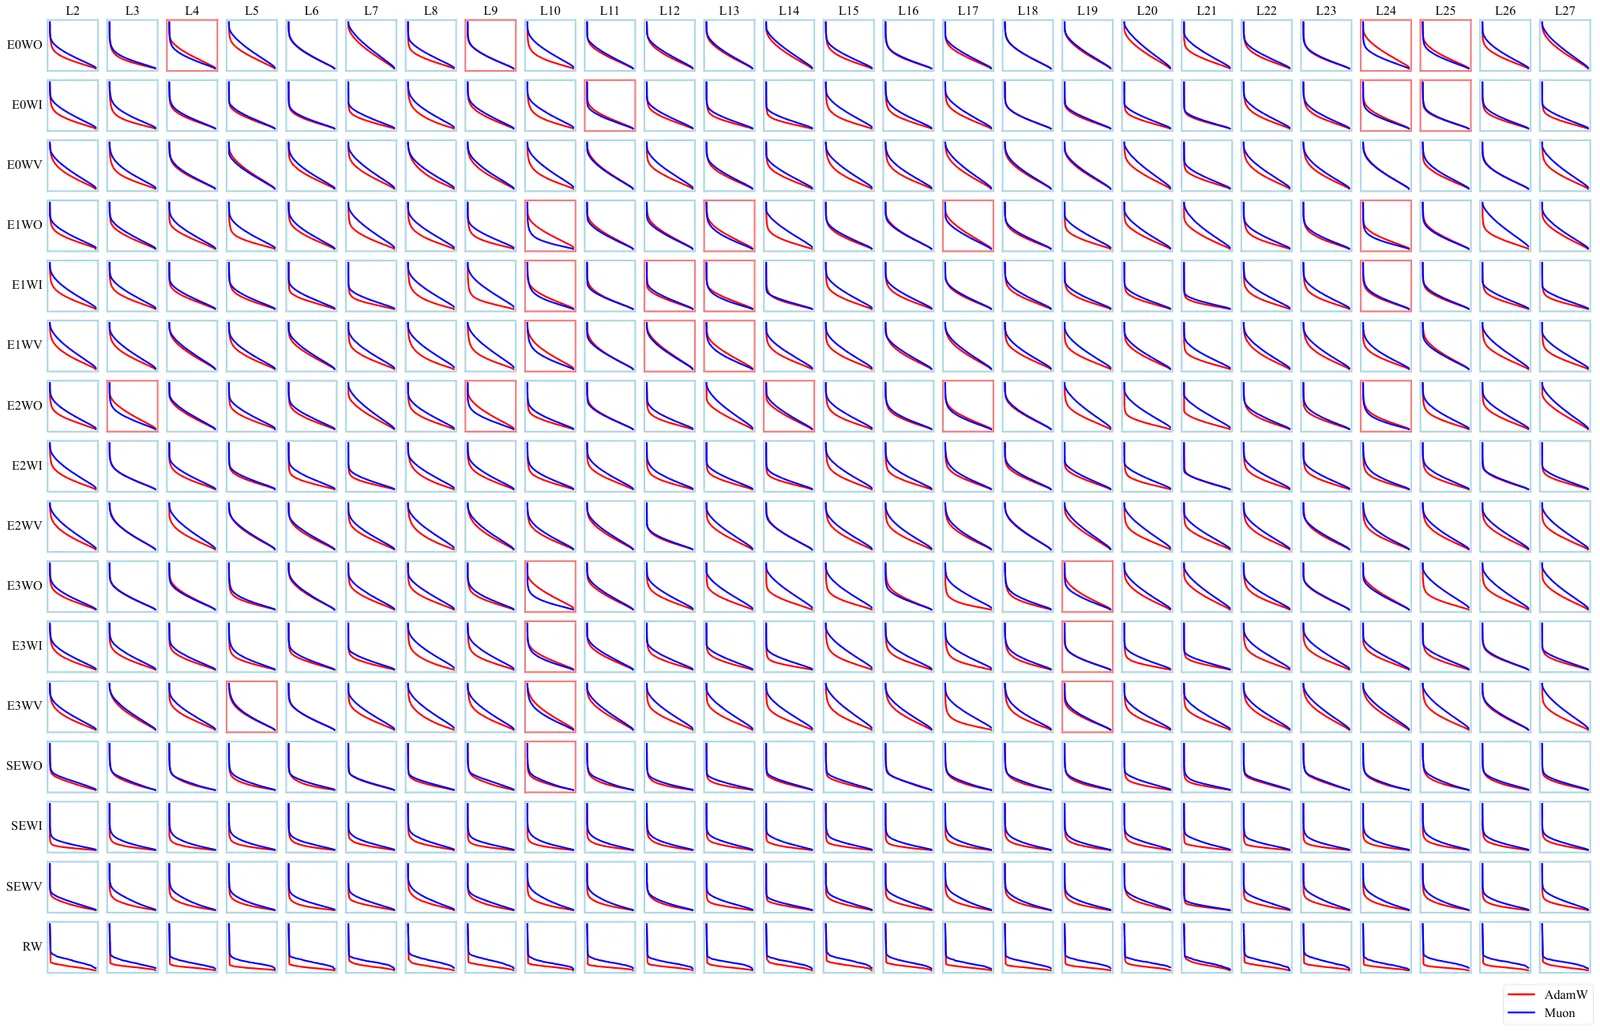
- 奇异值谱: Muon 训练的权重矩阵各层 SVD 熵都高于 AdamW,作者把它解读为 Muon 探索了权重空间里更多的方向。
Muon 不起作用的地方
把现有模型切到 Muon 之前,要记住 3.5 节。在 tulu-3 SFT 混合数据上微调 Qwen2.5-7B 这个用 AdamW 预训练的模型,Adam 得到 MMLU 71.4、HumanEval 79.3、GSM8K 89.8,Muon 是 70.8、77.4、85.8(表 7)。在 AdamW 预训练的模型上做 SFT,Muon 略差而不是更好。Moonlight 上的 2×2 消融(表 6)指出了原因:最好的格子是 Muon 预训练接 Muon SFT(MMLU 55.7,HumanEval 57.3,GSM8K 68.0),两个阶段之间换优化器,无论哪个方向都要丢几分。Muon 的收益来自它在预训练阶段建立的奇异值结构,它不是给别人的检查点做后训练时的即插即用改进。后续关于 Muon 和 AdamW 的区别 在预训练之外的研究,包括强化学习和机器人策略,发现了同类但更尖锐的失效。
局限与存疑
缩放律止于 1.5B 参数,旗舰模型是 16B 总参数的 MoE;论文没有展示 2 倍在前沿规模上成立,不过后来 DeepSeek-V4 和 Kimi K3 分别在 1.6T 和 2.8T 参数的预训练中采用了 Muon。2 倍这个数字来自拟合曲线,AdamW 基线的超参数本身经过搜索(附录 B),所以比较是公平的,但依赖具体模型家族。Muon 每次迭代对每个矩阵多一步 Newton-Schulz,分布式训练还要聚合完整矩阵,论文报告开销可控但不为零。非矩阵参数仍然留在 AdamW 上,如何把它们纳入同一框架,论文没有回答。
本文是 DeepSeek V4 架构解读, Kimi K3 架构解读, Qwen3.8-Next 架构解读 的来源论文之一。
常见问题
让 Muon 扩展到大模型训练的两处修改是什么?
一是加入 AdamW 式权重衰减,因为没有它权重和激活的 RMS 会增长到超出 bf16 的精确范围;二是把每个正交化更新乘以 0.2 倍较大矩阵维度的平方根,让更新 RMS 对齐 AdamW 常见的 0.2 到 0.4。第二处修改让 Muon 能复用为 AdamW 调好的学习率和权重衰减。
按这篇论文,Muon 比 AdamW 的效率高多少?
对 399M 到 1.5B 参数模型拟合的缩放律显示,Muon 达到同样损失只需约一半训练 FLOPs,论文表述为约 2 倍计算效率。在 1.2T token 的受控对比里,HumanEval 从 29.3 升到 37.2,MATH 从 16.1 升到 19.8,MMLU 持平。
微调一个用 AdamW 预训练的模型时,Muon 有帮助吗?
没有。在 Qwen2.5-7B 上,Muon SFT 得到 MMLU 70.8、GSM8K 85.8,Adam 是 71.4 和 89.8。Moonlight 的消融表明收益需要预训练阶段就用 Muon;跨阶段混用优化器无论哪个方向都会丢分。
Moonlight 是什么,怎么训练的?
Moonlight 是 Moonshot AI 用 Muon 在 5.7T token 上训练的 16B 总参数、2.24B 激活参数的混合专家模型。训练结束时 MMLU 70.0、HumanEval 48.1、MATH 45.3,领先于用相同 token 数和 AdamW 训练的 DeepSeek-V2-Lite。