
长上下文 · 高效 AI · Transformer
长上下文三条路对比:原生大窗口、稀疏 KV 与软 token 压缩
Gemini 1.5 把窗口扩到 1000 万 token,FlashMemory 只留 13.5% 的 KV 缓存,LCLM 在读入前压成软 token。三条路线,三层技术栈,三笔账。
三条路线
「一百万 token 的上下文怎么办?」这个问题,站里三篇论文给了三个结构完全不同的答案,区别很重要,因为每个答案动的是技术栈里不同的层。
路线一:把窗口本身做大。 Gemini 1.5 训练了一个算力高效的混合专家模型,上下文窗口越过 1000 万 token,并且真的测了:文本、视频、音频三种模态上,检索召回一直到 1000 万 token 都保持在 99% 以上。下游什么都不用改:没有淘汰策略、没有压缩器、没有检索管线。代价全部落在预训练上,以及推理时每一 token 的注意力账单上。
路线二:模型不动,选择性淘汰 KV 缓存。 FlashMemory-DeepSeek-V4 接受一个前沿模型原样不改,去打真正的瓶颈:50 万 token 上下文下,塞不进 GPU 的是 KV 缓存,不是模型权重。一个小型神经索引器预测接下来会查询哪些 KV 块,只有这些块留在显存里,平均物理缓存降到全量基线的 13.5%。
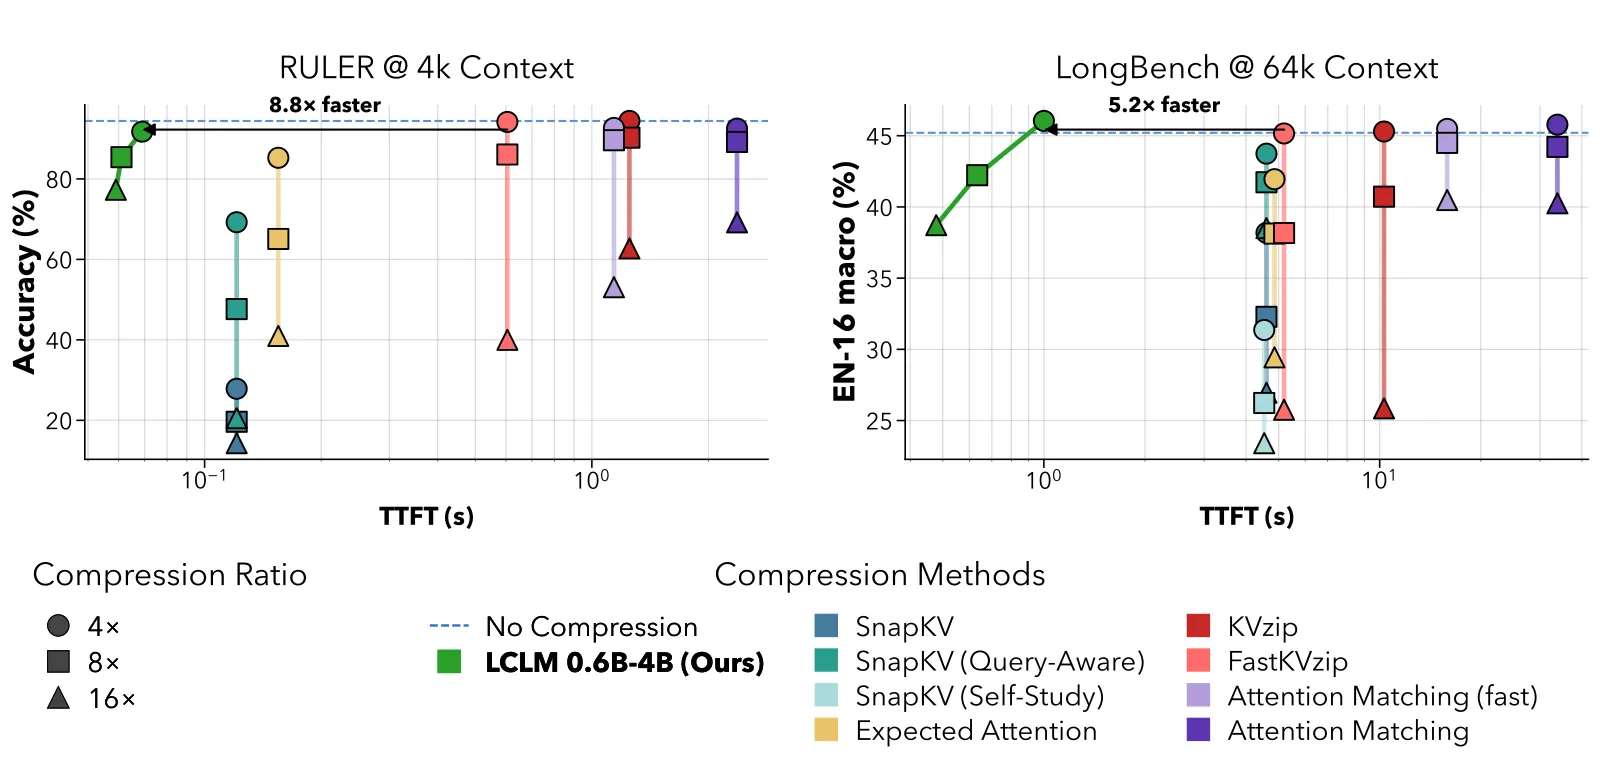
路线三:在模型读到之前就把上下文压掉。 端到端上下文压缩(LCLM)把节省前移:一个 0.6B 编码器按 1:4、1:8、1:16 的比例把输入块压成单个软 token,4B 解码器直接读这些隐变量,而不是完整序列。解码器从头到尾没编码过整篇文档,预填充时间和缓存都按比例缩小。
关键数字
| 测量项 | Gemini 1.5(大窗口) | FlashMemory(稀疏 KV) | LCLM(隐式压缩) | 出处 |
|---|---|---|---|---|
| 实证上下文长度 | 至少 1000 万 token 保持 99%+ 召回 | 50 万 token(超过 500K 未验证) | 往 512K–1M token 测 | 见上 |
| 显存效果 | 无,整个窗口常驻 | KV 缓存为全量基线的 13.5%(约 7 倍压缩);50 万 token 时压制 90% 以上开销 | 输入 token 数减至 1/4、1/8、1/16;峰值显存随上下文增长趋于平坦 | 见上 |
| 精度代价 | 召回基准 >99%;但对整窗深度多跳推理的测量并不是这个基准 | 三个基准上平均 +0.6%(LongBench-v2、LongMemEval、RULER) | 1:4 相对未压缩 4B 基线近乎无损;1:16 在精确召回上拉开可测差距 | 见上 |
| 额外训练 | 前沿级 MoE 预训练;Pro 以更低的服役成本追平 1.0 Ultra | 只训练索引器,按标准双编码器训练,主干全程不加载 | 0.6B 编码器 + 4B 解码器联合训练约 350B token,分四个阶段 | 见上 |
| 检索兜底 | 窗口本身就是检索面 | 前瞻预测在块变关键之前把它拉回 | EXPAND(i) 返回原始 512 token 块,买回大海捞针的精确率 | 见上 |
读这张表守住一条规则:这是三台不同的机器在三条不同的赛道上跑。Gemini 1.5 的 99% 是针式检索召回,且模型本来就是为它建的;FlashMemory 的 +0.6% 是相对于自己稠密基线的稀疏化差值;LCLM 的「无损」是相对 4B 模型,不是相对前沿模型。跨行的同口径对比不存在。
各自把钱花在哪
大窗口是均匀地处处花钱。 1000 万 token 上的注意力最坏是平方级,Gemini 1.5 于是给窗口配上混合专家,让每 token 算力可控;报告的成本主张是 1.5 Pro 以更便宜的服役成本追平上一代旗舰 1.0 Ultra。这套经济学成立是因为预训练成本由 Google 摊掉;自己服役模型的团队要付的是整个前沿账单。而且窗口大不等于推理大:在 1000 万 token 里定位一个事实是已解决的基准形状,把散落全窗的证据综合起来不是,检索类基准测不到后者。卡拉曼语的结果,只靠放进上下文的一本语法书就学会翻译一个使用者不足 200 人的语言,才是这个窗口真正用途的更持久证明:上下文内习得技能,而不是搜索。
稀疏 KV 把钱花在一个要额外服役的模型上。 FlashMemory 的索引器是真组件:它带来延迟,要和一个双编码器一起部署,而且它的质量就是全部胜负。一次预测失误,丢掉的那块恰好藏着答案,这在针式查询上不是边角案例而是灾难现场。三个基准平均 +0.6% 是让人放心的讲法,但平均值会掩盖单次的灾难性失手。补偿性的设计是「前瞻」:不按过去注意力了什么来决定保留谁,而是预测下一个 span 需要什么,于是安静了几千个 token 后突然变得关键的块,可以在被用到之前拉回来。
隐式压缩把钱花在训练上,然后在每次请求上省回来。 LCLM 约 350B token、四阶段(适配器预热、编码器训练、端到端持续预训练、监督微调)的配方,是把压缩从推理期启发式搬进训练组件的代价。回报是结构性的:SnapKV、KVzip 这类 KV 缓存淘汰是在模型已经付完编码账之后才压缩,所以压缩时间基本固定;LCLM 在编码器里、在解码器之前压缩,比例越高压得越快:1:16 要生产的软 token 比 1:4 少,生产工作就更少。高压缩下 LCLM 峰值显存随上下文增长趋于平坦,而 Attention Matching 基线在同样硬件上 512K 到 1M token 附近就显存耗尽。代价是:编码器窗口 W=1024,超长输入会跨窗口边界,跨边界信息被切开;解码器读隐变量仍要付费,极端长度下编码器侧的节省会封顶。
怎么选
- 模型、预算、产品形态都在你手里,想要最简架构: 大窗口。Gemini 1.5 证明了窗口本身可以就是检索系统,代价是整个前沿预训练。
- 已经在服役现成的前沿模型,50 万 token 请求显存撑不住: 稀疏 KV。FlashMemory 平均缓存降到 13.5%、精度持平到 +0.6%,是侵入最小的修法;索引器按双编码器解耦训练,小团队真的跑得起。
- 预填充成本和首 token 延迟是主要矛盾、能接受训练、4B 级质量够用: 隐式压缩。LCLM 在 1:4 接近免费;1:16 是用精确召回换显存的明确交易。EXPAND 工具是实用桥梁:默认全压缩,按需取原始块。
- 任务需要超长文档的精确召回且以上都不适用: 哪个都替代不了检索管线。三篇论文都在含蓄承认这一点:Gemini 1.5 只测针式召回不测多跳综合;FlashMemory 靠预测把块拉回来;LCLM 加 EXPAND。
局限与存疑
诚实的缺口是:没有一个受控实验在同一模型、同一套基准、同一硬件预算下对头比较这三条路线。FlashMemory 的数字是相对自己稠密 DeepSeek-V4 基线的差值;LCLM 是相对未压缩 4B 解码器的;Gemini 1.5 是一份能力报告,根本没有压缩对照。LCLM 的模型是 0.6B 和 4B,联合压缩训练能否迁移到前沿规模解码器、能否越过 1:16,都没验证。FlashMemory 绑死单一主干,LSA 迁移到其他架构、或越过 500K 表现如何,仍是开放的。而「窗口 1000 万 token」始终意味着「检索在 1000 万 token 内成立」,这是比「模型能对 1000 万 token 推理」弱得多的主张。这些路线之外还要面对的机制(KV 缓存量化、注意力头特化稀疏、以及朴素的稀疏注意力),见 KV 缓存压缩解读与 稀疏注意力与全量注意力对比。
常见问题
长上下文有哪几种实现方法?
三种:把原生窗口做大(Gemini 1.5,至少 1000 万 token 保持 99%+ 召回);解码期稀疏化 KV 缓存(FlashMemory,50 万 token 下缓存为全量的 13.5%);在读入前把上下文压成软 token(LCLM,0.6B 编码器 + 4B 解码器,1:4 到 1:16)。
三种路线对比:哪种精度损失最小?
按各论文自己报告的数字:FlashMemory 在三个基准上平均 +0.6%,LCLM 在 1:4 下相对未压缩 4B 基线近乎无损,LCLM 在 1:16 的精确召回任务上拉开可测差距。但这是不同模型不同评测口径,没法用一个跨论文的数字回答「谁最小」。
1000 万 token 窗口和 RAG 的区别是什么?窗口会取代检索吗?
不会。Gemini 1.5 的报告测的是针式检索召回,不是对整个窗口的深度综合,而且长提示又贵又慢。FlashMemory 和 LCLM 最后都重新引入了检索形状的机制(前瞻预取块和 EXPAND 工具),这本身就是业界承认:搜索和上下文解决的是不同问题。
如何最省钱地伺候 50 万 token 上下文?
模型已存在:FlashMemory 式稀疏 KV,索引器按独立双编码器训练、全程不加载主干,平均驻留缓存降到 13.5%。能从头训练小系统:LCLM 式压缩,显存随上下文增长趋于平坦,而淘汰类基线在 512K 到 1M token 附近就显存耗尽。
为什么 LCLM 压缩比例越高反而越快,KV 缓存方法却不这样?
KV 缓存淘汰(SnapKV、KVzip)发生在模型把每个 token 都编码完之后,所以不管选什么比例,压缩成本大致固定。LCLM 在解码器之前、在编码器里压缩,1:16 比 1:4 少生产四分之三的软 token,要生产的 token 越少,压缩工作越少。